Group Meeting · Report 02 · Paper Reproduction
SmartEars:用声音发现病鸡基于声谱图分类的鸡呼吸道疾病监测——原理、复现、结果与可做的创新
原论文:Qiao H., Chen Z., et al. SmartEars: A practical framework for poultry respiratory monitoring via spectrogram-based audio classification and AI-assisted labeling. Computers and Electronics in Agriculture, 2026, 241: 111241. doi:10.1016/j.compag.2025.111241
版权说明:原论文为 Elsevier 版权保留,本页只做摘要级转述,所有图表均为本人代码生成;数据集 Mendeley dy6gtvt4mk 为 CC BY 4.0。 标签:本人实测 论文资料
01为什么从 13 篇里选这篇
选题标准只有一条:我能在自己电脑上完整跑通,并且数字能和论文对上。逐篇查了「ppt学习」里 13 篇论文的数据可用性声明:
| 候选论文 | 数据公开? | 能否复现 |
|---|---|---|
| SmartEars 鸡呼吸道声音(本篇) | 是 · Mendeley CC BY 4.0,6000 段 | 能 |
| 小鸡咳嗽检测(改进 AST) | 「可向作者索取」 | 暂不能 |
| 蛋黄 ¹H NMR 判别饲养方式 | 明确不公开 | 不能 |
| 死鸡检测、黑色素分级、胴体分割等中文期刊 | 未提供数据 | 只能换数据仿做 |
另外,汇报 01 做的是「看」(视觉检测),这篇是「听」——种鸡健康监测需要声音这一路信号,方法可以直接迁移。
02论文讲了什么论文资料
问题:呼吸道病(传染性鼻炎、新城疫、传支、禽流感……)的早期症状是喷嚏、咳嗽、啰音。现在靠兽医夜里巡舍「听」,覆盖不全、人一靠近鸡就不叫;已有研究多在实验室单只鸡上做,扛不住真实鸡舍的风机、人声、踢笼声。论文还发现:3 位兽医对同一批 799 段标注,三人完全一致只有 28.79%。
- 硬件:树莓派 4B + USB 麦克风,每间鸡舍过道顶部 7 台,本地推理,不依赖网络。
- AI 辅助标注:兽医看声谱图标注 → 模型重新预测全部数据 → 不一致的交回兽医复核,迭代清洗;最终把三类合并为「病 / 正常」二分类。
- 特征 + 增强:5 s 片段 → 499×128 Logfbank;五种信号级增强代替图像增强。
- 选型:比较 RNN、LSTM、AlexNet、VGG16、ResNet50、MobileNetV3、Swin、RegNet,RegNet 综合最好。
- 报警:每 5 分钟对一个区域的识别结果加权、夜间权重更高,避免偶发咳嗽直接报警。
03原理:把「听」变成「看」
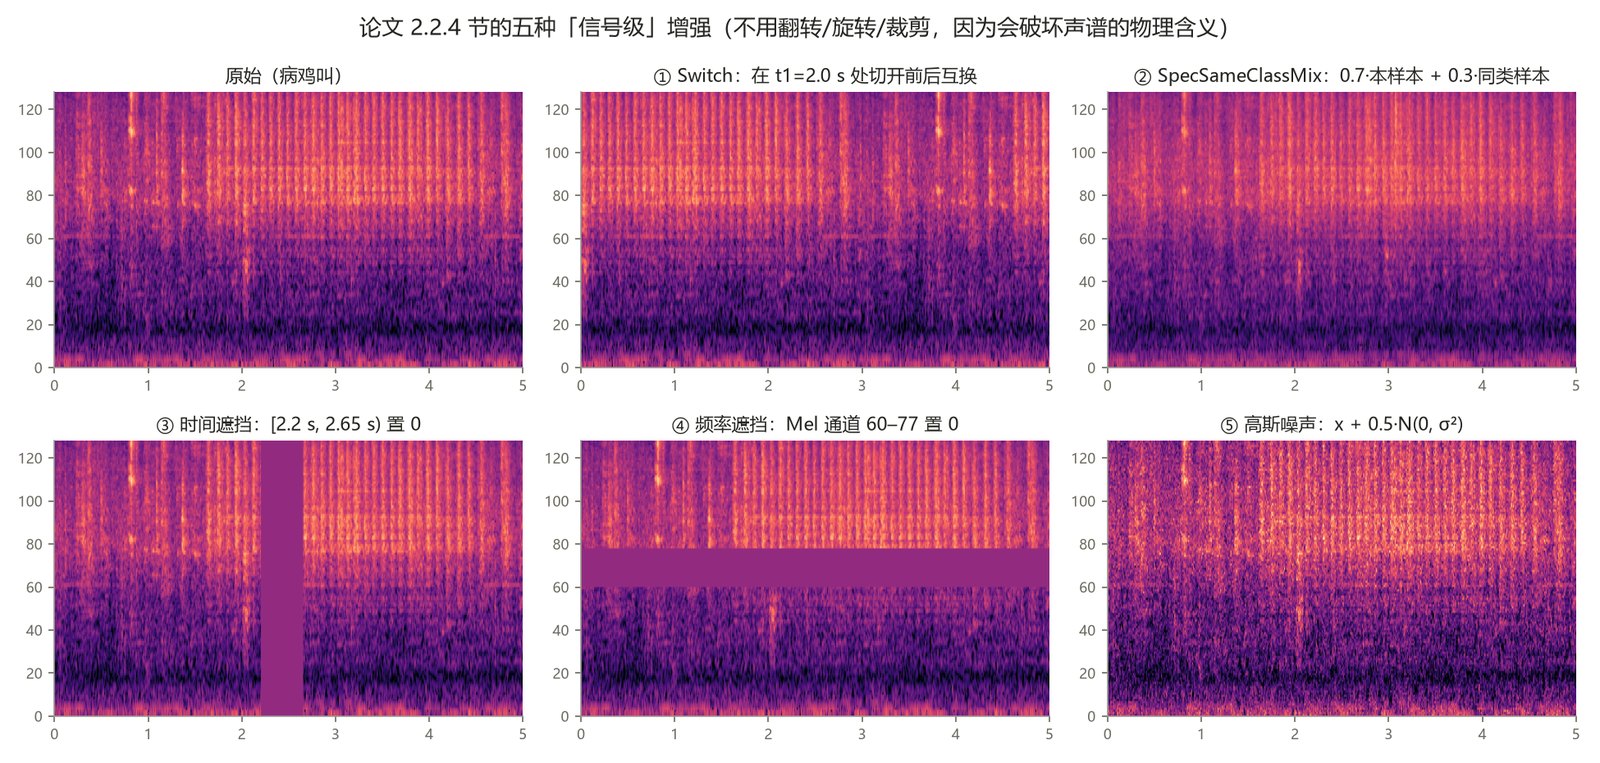
声谱图横轴是时间、纵轴是频率、亮度是能量。咳嗽/喷嚏在图上是短促的竖向亮条,于是可以借用成熟的图像 CNN 来分类。
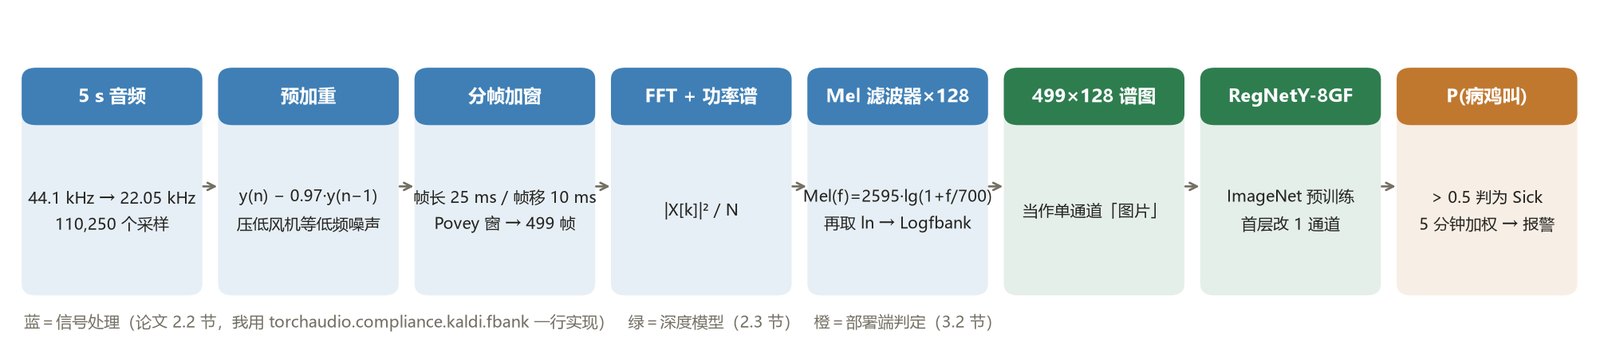
- 预加重 y(n) − 0.97·y(n−1):一阶高通,压低风机、踢笼等低频噪声。
- 帧长 25 ms / 帧移 10 ms:声音在 10–30 ms 内近似平稳;22.05 kHz 下 5 s 得到 (110250−551)/220 + 1 = 499 帧。
- Logfbank 而不是 MFCC:MFCC 就是 Logfbank 再做一次 DCT,少一步计算、信息不丢,更适合树莓派。
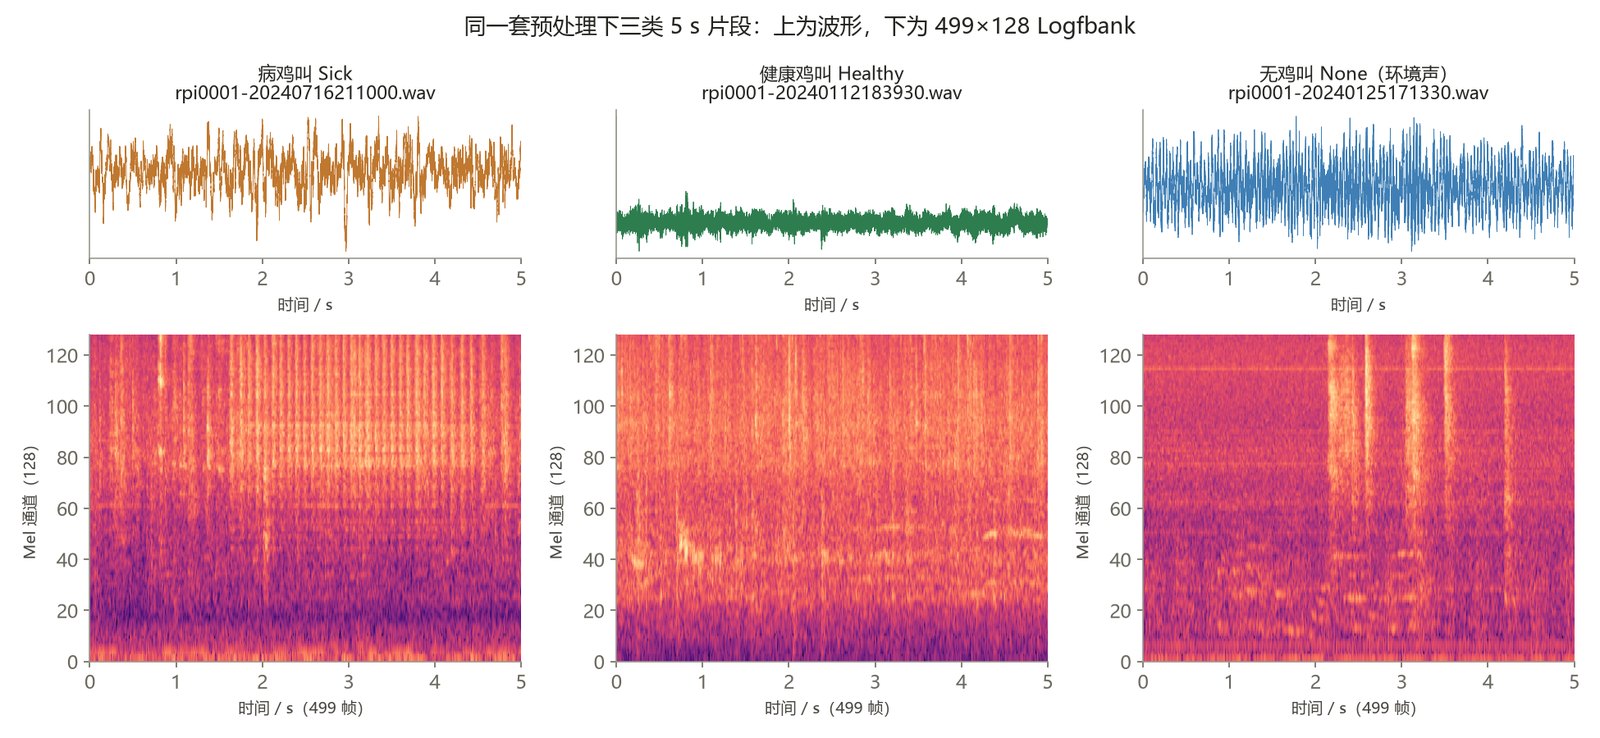
五种「信号级」数据增强
翻转、旋转、裁剪会改变声谱的物理含义(频率上下颠倒就不是同一个声音了),所以论文只用下面五种。论文没给概率和遮挡长度,下表具体数值为本人设定:
| 增强 | 做法 |
|---|---|
| ① Switch | 随机时间点切开,前后两段互换 |
| ② SpecSameClassMix | z = r·x + (1−r)·y,y 为同类样本,r∈[0.5, 1] |
| ③ 时间遮挡 | 随机一段 ≤ 50 帧(0.5 s)置 0 |
| ④ 频率遮挡 | 随机 ≤ 20 个 Mel 通道置 0 |
| ⑤ 高斯噪声 | x + 0.5·N(0, σ²),σ 取训练集;每种增强各以 50% 概率触发 |
论文设置 vs 本机复现
| 项目 | 论文 | 本机复现 |
|---|---|---|
| 数据 | 私有 32,891 段,二分类 | 公开 6,000 段(三类各 2000 → 合并为 Sick vs Normal) |
| 划分 | 独立测试 2,772 段 + 训练/验证 8:2 | 每类 70/10/20 分层随机;另做按设备划分 |
| 采样率 | 22.05 kHz | 公开文件为 44.1 kHz,重采样到 22.05 kHz |
| 模型 | RegNet,37.4 M | torchvision RegNetY-8GF,37.4 M(一致);预训练首层权重求和改 1 通道 |
| 训练 | BCE / Adam 1e-4 / batch 128 / ≤500 轮,早停 100 | BCE / Adam 1e-4 / batch 32 / ≤20 轮,早停 6(与 YOLO 训练共用 GPU) |
04如何实现:四个脚本本人实测
# 0) 环境(RTX 50 系必须 cu128)
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu128
pip install soundfile matplotlib python-pptx

# 1) 下载公开数据(CC BY 4.0)
curl -L -o smartears.zip https://data.mendeley.com/public-api/zip/dy6gtvt4mk/download/2

# 2) Logfbank:一行对应论文 2.2 节全部参数
fb = torchaudio.compliance.kaldi.fbank(x, sample_frequency=22050, frame_length=25, frame_shift=10,
         num_mel_bins=128, window_type="povey", preemphasis_coefficient=0.97)   # → 499×128

# 3) 训练 + 独立测试集评估(Sick 为正类,输出 Acc/Prec/Rec/F1/MCC 与推理耗时)
python train.py --model regnet --aug 1 --split random --epochs 20 --patience 6 --tag A_regnet_aug
代码在 J:\poultry\smartears\。踩坑:增强最初用 Python 循环逐样本做,96 s/轮;改成 GPU 上向量化(gather 做循环移位、布尔掩码做遮挡)后 32 s/轮。与 YOLO 训练共用显卡时用 set_per_process_memory_fraction 限制本进程显存,避免把对方挤爆。
05运行截图本人实测
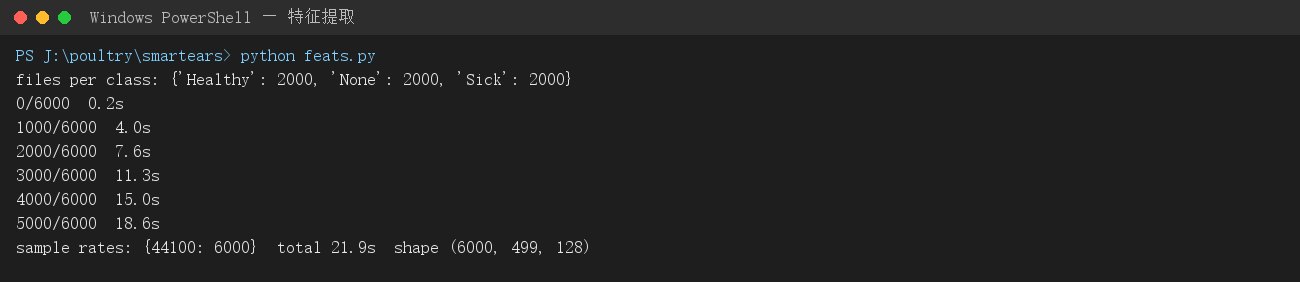
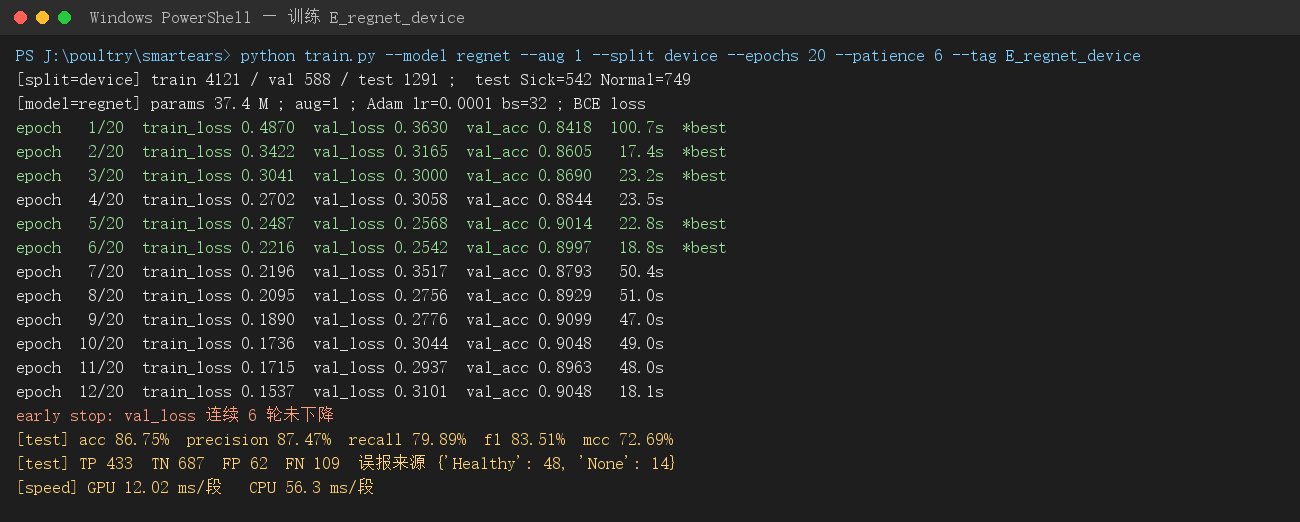
终端画面由本机真实日志逐行渲染,内容未改动。
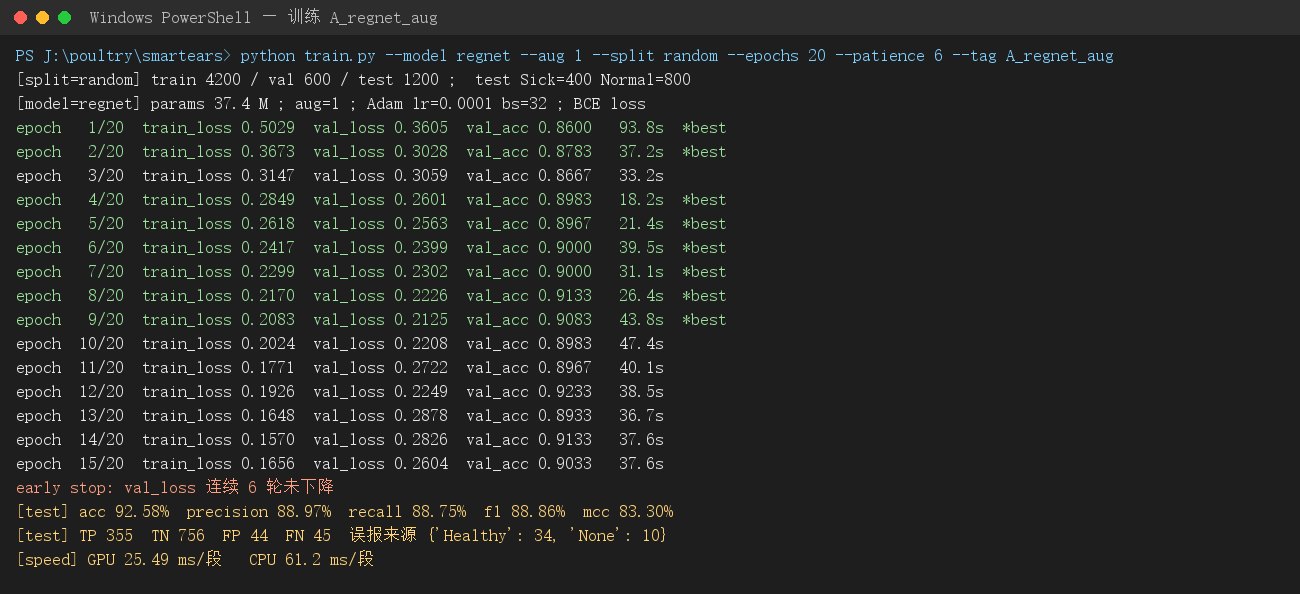
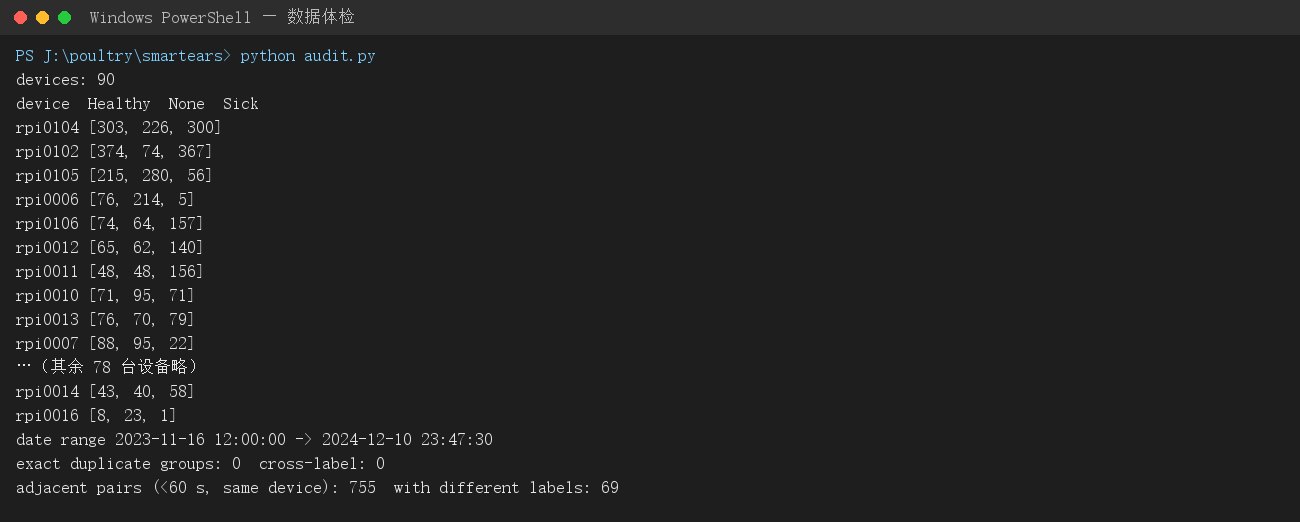
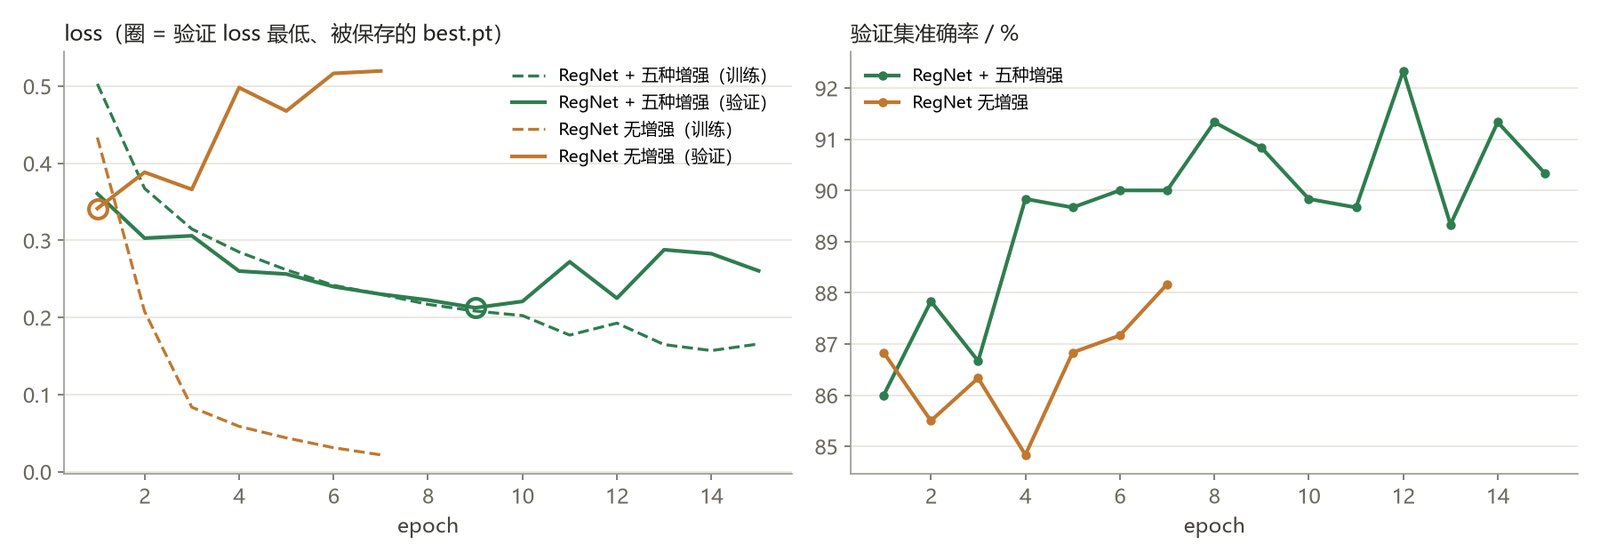
06复现结果本人实测
| 指标 (%) | 论文 表 4 | 本机实验 A |
|---|---|---|
| Accuracy | 96.03 | 92.58 |
| Precision | 91.25 | 88.97 |
| Recall | 95.36 | 88.75 |
| F1-score | 93.26 | 88.86 |
| MCC | 90.49 | 83.30 |
差距在预期内:
① 数据只有论文的 1/5(6000 vs 32,891 段);
② 最多只训了 20 轮(论文最多 500 轮),且与 YOLO 训练共用 GPU;
③ 测试集不同,论文测试集经兽医反复核验。
结论一致:加增强后召回率大幅提高,RegNet 可用。
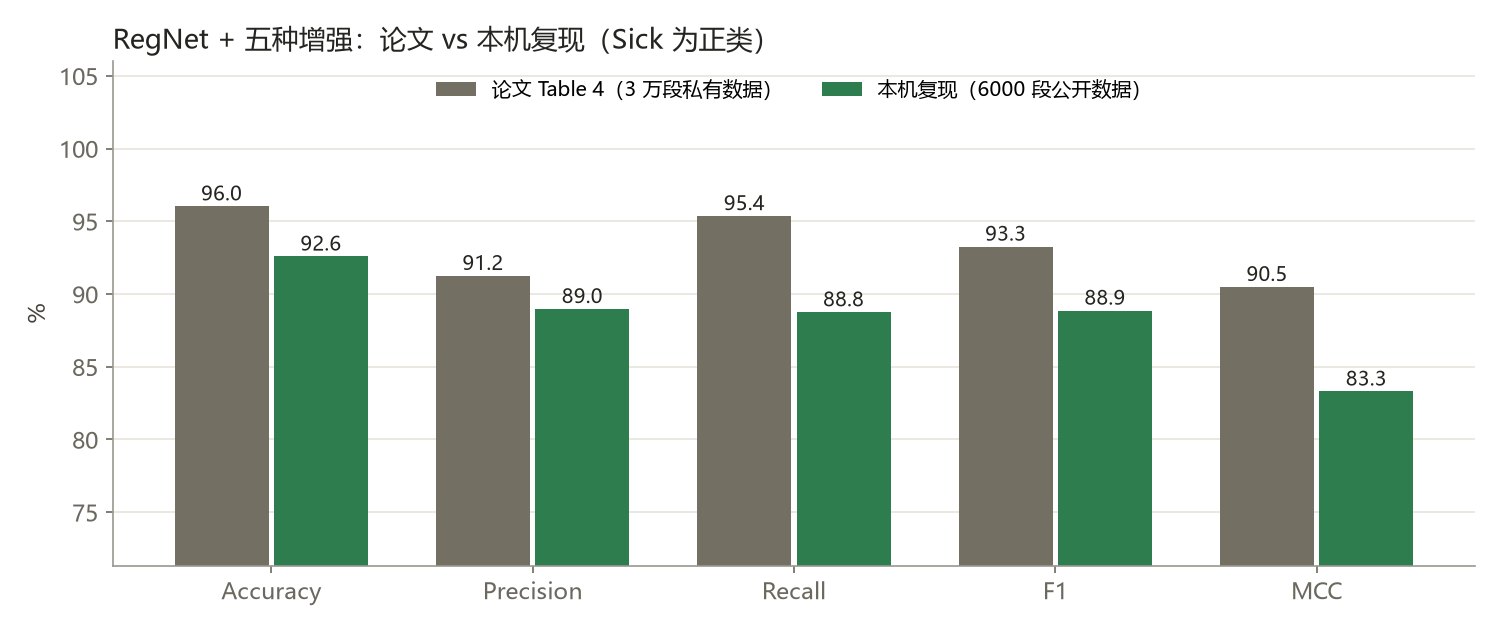
六组实验全表
| 实验 | Acc | Prec | Rec | F1 | MCC | 参数 M | 轮数 | 每轮 | CPU 推理 |
|---|---|---|---|---|---|---|---|---|---|
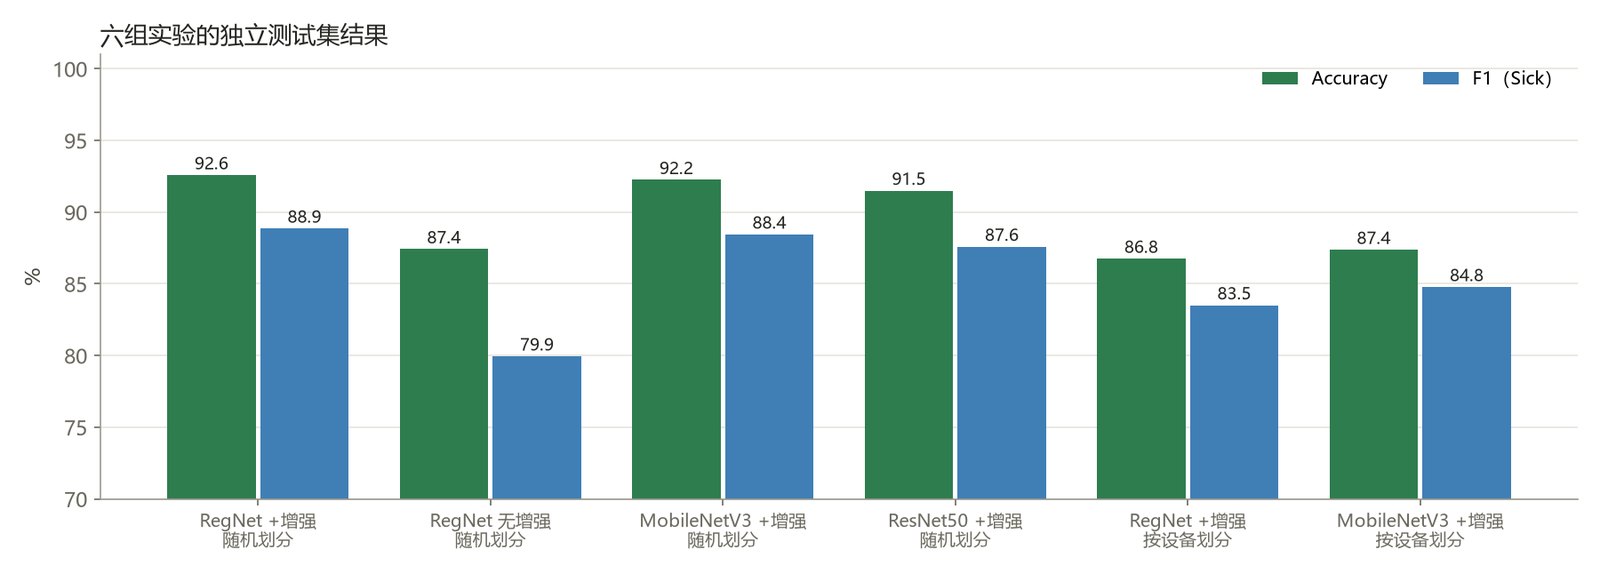
| A · RegNet + 五种增强 · 随机划分 | 92.58 | 88.97 | 88.75 | 88.86 | 83.30 | 37.4 | 15(best 9) | 39 s | 61 ms |
| B · RegNet 无增强 · 随机划分 | 87.42 | 85.27 | 75.25 | 79.95 | 71.12 | 37.4 | 7(best 1) | 35 s | 89 ms |
| C · MobileNetV3 + 增强 · 随机划分 | 92.25 | 87.90 | 89.00 | 88.45 | 82.62 | 4.2 | 20(best 19) | 10 s | 7 ms |
| D · ResNet50 + 增强 · 随机划分 | 91.50 | 85.31 | 90.00 | 87.59 | 81.20 | 23.5 | 15(best 9) | 10 s | 35 ms |
| E · RegNet + 增强 · 按设备划分 | 86.75 | 87.47 | 79.89 | 83.51 | 72.69 | 37.4 | 12(best 6) | 39 s | 56 ms |
| F · MobileNetV3 + 增强 · 按设备划分 | 87.37 | 85.82 | 83.76 | 84.78 | 74.01 | 4.2 | 20(best 19) | 10 s | 11 ms |
① 增强消融复现成功
无增强 → 有增强:准确率 87.42 → 92.58(+5.16),召回率 75.25 → 88.75。论文为 91.56 → 96.03(+4.47),趋势一致。
② 轻量模型几乎不掉点
MobileNetV3 只有 4.2 M 参数,准确率 92.25%,只比 RegNet 低 0.33 个点;本机 CPU 推理 7 ms/段,RegNet 61 ms/段,快约 8 倍。
③ 与论文的差别
论文中 RegNet 第一、ResNet50 精确率最高;在 6000 段小数据上三者差距在 1 个点以内,排序不稳定,不能下「谁最好」的结论。
误报主要来自健康鸡叫
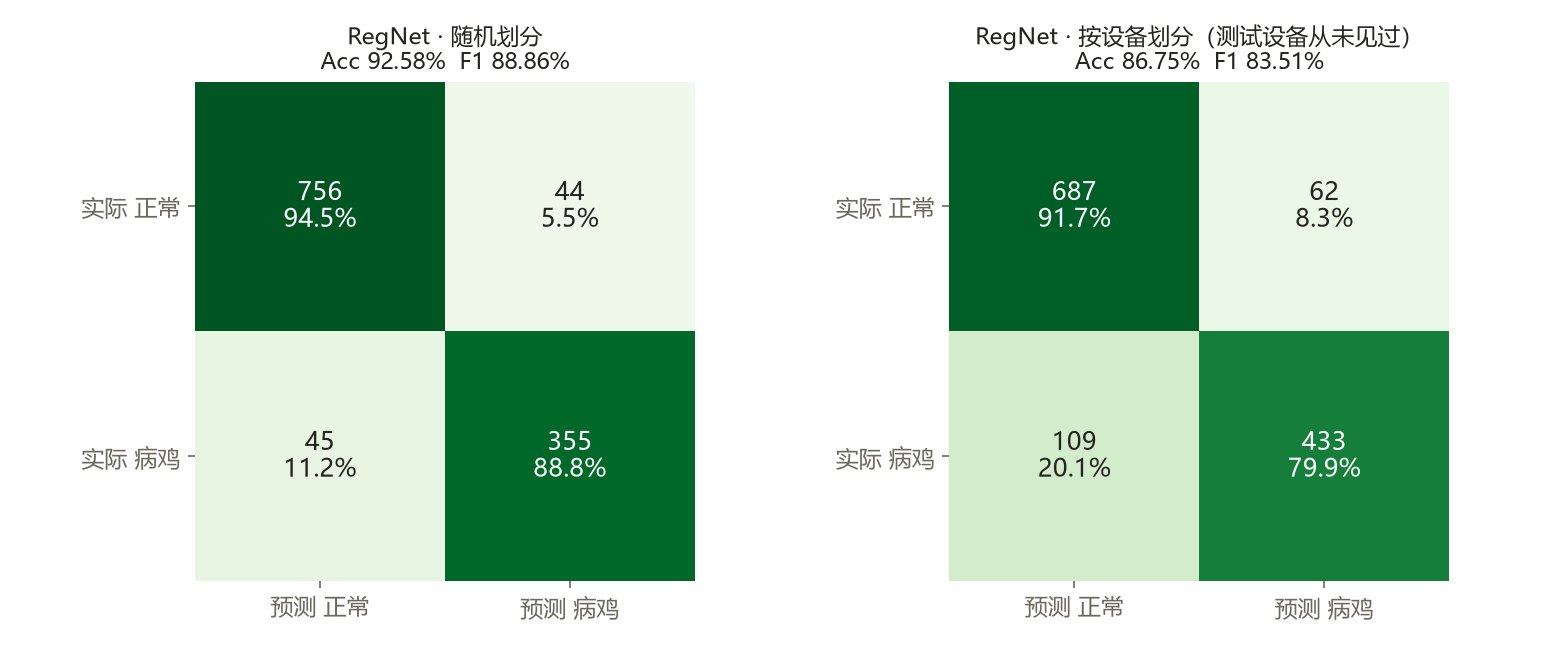
实验 A 的 44 个误报中,34 个是 Healthy、只有 10 个是 None(环境声)。说明模型区分「鸡叫 vs 环境声」不难,难的是「健康鸡叫 vs 病鸡叫」——这与论文中兽医之间一致率低的发现吻合。
换到新设备后漏报变多
按设备划分时,病鸡片段的漏报率从 11.3%(45/400)升到 20.1%(109/542)。对报警系统来说,漏报比误报更危险。
07我的发现:随机划分可能高估效果本人实测
和汇报 01 对 PIO 做数据体检的思路一样——先检查数据,再相信指标。
- 文件名里藏着设备和时间:
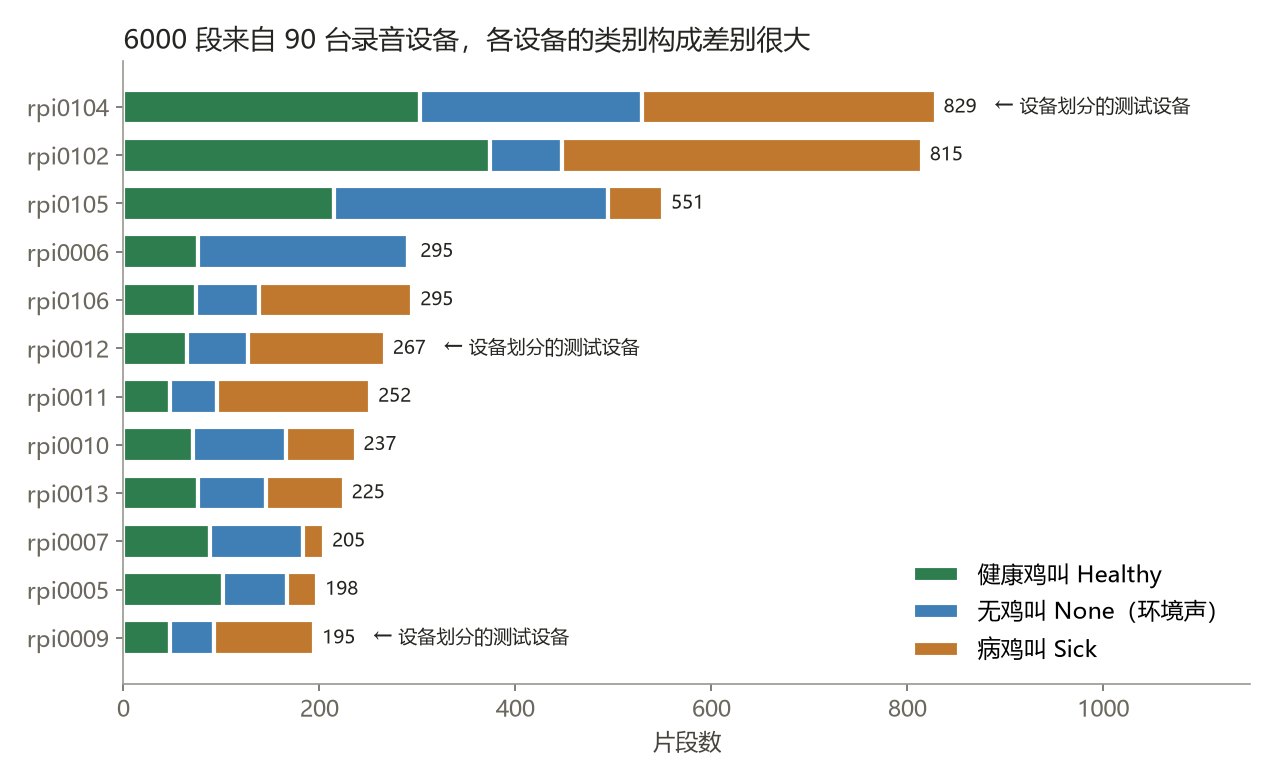
rpi0104-20240103205100.wav= 设备号 + 录音时刻;6000 段来自 90 台设备,2023-11 至 2024-12。 - 同一次录音被切成相邻片段:同一设备 60 s 内相邻的片段有 755 对;随机划分时,同一段录音的前后 5 秒可能分别落在训练集和测试集。
- 设备与类别强相关:rpi0006 有 214 段环境声却只有 5 段病鸡,rpi0101 有 109 段病鸡——模型可能在学「这是哪台设备」而不是「是不是咳嗽」。
08创新点本人实测
| 模型 | 划分 | Accuracy | F1 | MCC | Recall |
|---|---|---|---|---|---|
| RegNet | 随机 | 92.58 | 88.86 | 83.30 | 88.75 |
| RegNet | 按设备 | 86.75 | 83.51 | 72.69 | 79.89 |
| MobileNetV3 | 随机 | 92.25 | 88.45 | 82.62 | 89.00 |
| MobileNetV3 | 按设备 | 87.37 | 84.78 | 74.01 | 83.76 |
结果
RegNet:MCC 83.30 → 72.69(−10.6),F1 88.86 → 83.51,召回率 88.75 → 79.89。
MobileNetV3:MCC 82.62 → 74.01(−8.6),换设备后反而略好于 RegNet。
解读
随机划分的数字有一部分来自「认得这台设备、这段录音」;新装设备时真实效果要打折扣。
两种划分的测试集类别比例不同(病鸡占 33% vs 42%),所以更应看 MCC、F1,而不是准确率。
意义:给「部署到新鸡舍」提供了更诚实的指标。
还可以做、并且能落地的方向
- 轻量化边缘部署(已有实测数据):MobileNetV3 已实测:参数少 9 倍、准确率只低 0.33 个点、CPU 推理快约 8 倍,换设备时更稳。下一步:导出 ONNX/INT8,在树莓派上实测功耗和耗时。
- 设备无关的特征归一化(1–2 周可验证):每台设备的麦克风、位置、风机不同。可做「按设备减去平均谱」或加域对抗损失,目标是把按设备划分的 MCC 从 72.7 拉回 80 以上。
- 片段 → 时间窗的聚合评估(现有数据可做):论文用 5 分钟加权报警但没给量化指标。数据里有 755 对相邻片段,可以评估「连续 N 段投票」能把漏报/误报降多少,直接对应报警策略。
- 声音 + 视觉融合(接我的课题)(课题主线,需自有数据):声音负责「哪一片有异常」,摄像头 + 汇报 01 的检测模型负责「是哪只鸡」。种鸡舍里先用声音缩小范围,再用视觉定位个体。
Collaboration Loop
协同思考:这次汇报能给别人什么、想向别人借什么
① 我做了什么
从 13 篇论文里按数据可用性筛出 SmartEars;下载公开数据 6000 段,按论文参数实现 Logfbank、五种增强和 RegNet 训练。
跑完 6 组对照:复现出准确率 92.58%(论文 96.03%),增强带来 +5.16 个点,与论文趋势一致。
做数据体检,发现随机划分存在设备/录音泄漏风险,用按设备划分给出更可信的指标(MCC 72.69)。
② 我的什么可以被其他方向复用
「声音 → Logfbank → CNN」这条流程不挑物种:马岗鹅的叫声异常、鸡舍风机故障声都能直接套用 feats.py + train.py。
「先查文件名/来源,再按来源分组划分」的防泄漏思路:适用于任何多摄像头、多设备采集的数据集(和汇报 01 的 PIO 体检同一套方法)。
GPU 共用时限制显存、增强向量化的经验。
③ 我想向其他同学借鉴什么
向做马岗鹅的同学了解开放环境下的录音条件和噪声,看这套模型能不能直接用在鹅上。
向做农业智能体的同学对齐接口:声音报警 → 智能体调取摄像头 → 给出诊断建议。
希望有兽医背景的同学/老师帮忙听一小批自采的种鸡声音,建立我们自己的标注样本。