Group Meeting · Report 01
种鸡 / 家禽智能监测从公开数据集到自己的检测实现
标签说明:本人实测 在本机亲手跑出/检查出的数据 公开资料 来自论文或已有资料
01背景:规模化鸡舍为什么必须靠算法
几千到几万只规模的鸡舍,日常管理长期依赖人工巡视——数鸡、看精神状态、找病鸡、观察采食,做不到连续、个体级别的观测:
- 只能抽样:一名饲养员管上万只鸡,鸡舍深处的个体照看不到。
- 进场即惊扰:鸡只聚集、踩踏、停止采食,观测本身改变了被观测对象。
- 夜间与短时异常抓不到:人工巡检一天只有几次,时间窗口太粗。
- 标准因人而异:「精神好不好」靠经验,无法沉淀成可量化、可复现的指标。
目标:用「摄像头 + 检测算法」替代「人的眼睛」——逐图计数、个体定位、框内再分析。
为什么是目标检测
| 方案 | 能回答什么 | 为什么不够用 |
|---|---|---|
| 人工巡检 | 全部问题,但只是抽样 | 效率低、有应激、不连续、主观 |
| 称重台 / 环境传感器 | 群体平均体重、温湿度 | 只有群体均值,定位不到个体 |
| 红外对射 / 光电计数 | 粗略「过了多少只」 | 拥挤同时通过时失效 |
| 传统图像处理 | 稀疏场景下的数量估计 | 参数逐场景手调,换鸡舍就失效 |
| 图像分类 CNN | 「这张图里有没有鸡」 | 回答不了「在哪、有几只」 |
| 目标检测 | 有没有 + 在哪 + 是什么,逐个个体输出 | 需要标注数据与算力——正是本课题要补的 |
02两套公开数据集,互为补充公开资料
笼养蛋鸡的精细化多模态观测 × 规模化肉鸡的复杂场景检测——在采集设备、场景尺度、标注规模上互补。
| 对比项 | BClayinghens | PIO |
|---|---|---|
| 对象 | 笼养蛋鸡 | 地面平养肉鸡 |
| 模态 | 可见光(RGB)+ 热红外(TIR) | 可见光(RGB) |
| 图像数量 | 61,133 | 1,487 |
| 标注量 | 63,693 个鸡头 | 327,288 个实例 |
| 采集时段 | 2022.04 – 2024.07 | 2023 年,连续 6 周 |
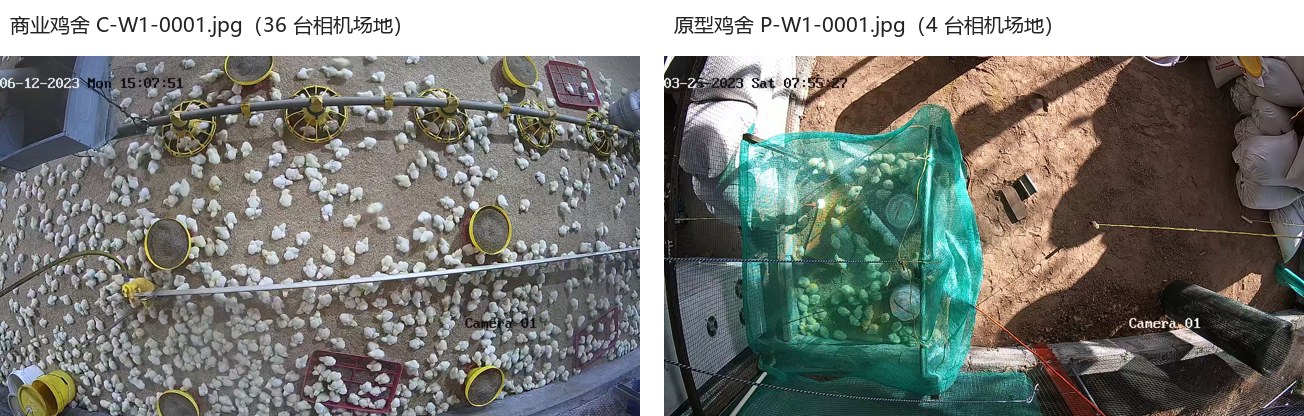
| 场景 | 5 个蛋鸡舍,约 960 笼位/轮 | 1 个商业鸡舍 + 1 个原型鸡舍 |
| 发表 | Sensors 2024, 24(19), 6385 | Scientific Data 2026, 13:801 |
BClayinghens · 笼养蛋鸡 RGB-TIR
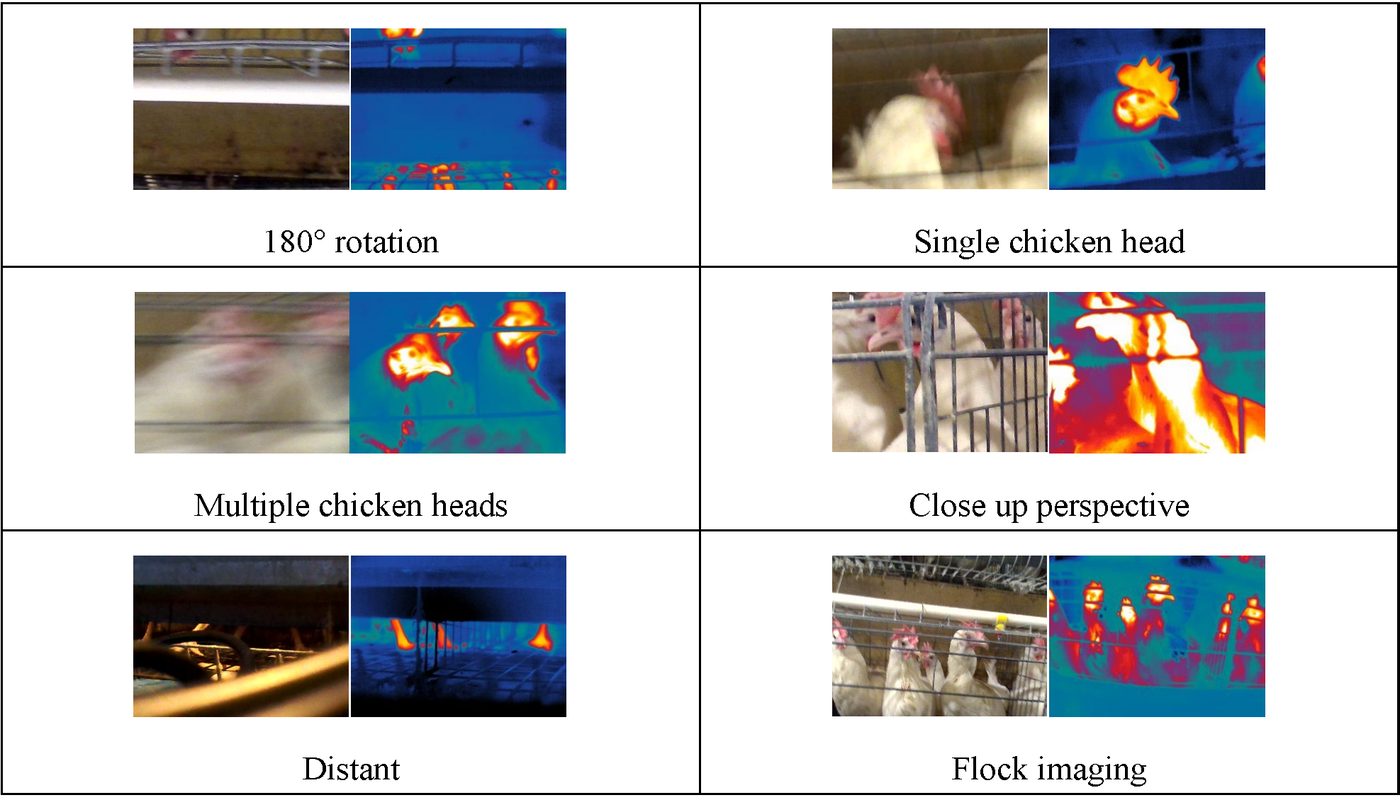
- 巡检机器人沿磁导航轨道;可见光 1920×1080 + FLIR A300 热像仪(9 Hz,320×240),间隔约 1 秒、后期坐标对齐。
- 10 列 × 8 层笼架,每笼 6–8 只,日龄 200–300 天。
- 可用于鸡头检测、跟踪、姿态、行为、个体识别、鸡头温度与健康评估。
- 增强:R 通道随机增强(ΔR ∈ [10,100])、色相/亮度、高斯噪声(σ=51)、拉普拉斯与泊松噪声。
PIO · 规模化肉鸡检测
- 1,920×1,088,YOLO 格式框,覆盖第 1–6 周完整生长周期。
- 原型鸡舍 4 台相机、每帧约 100 只;商业鸡舍 36 台、每帧约 700 只。
- Hikvision DS-2CD1027G0-L;OpenCV 多进程每段视频抽 250 帧;附原始视频可二次抽帧。
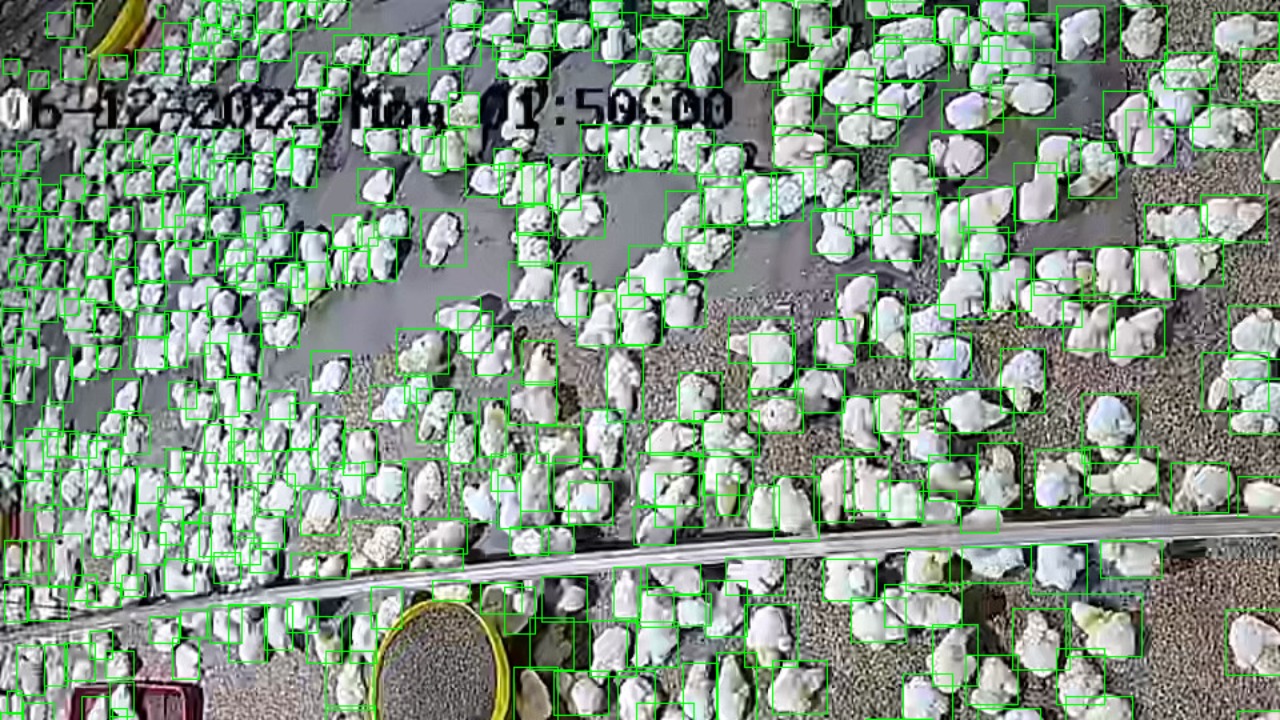
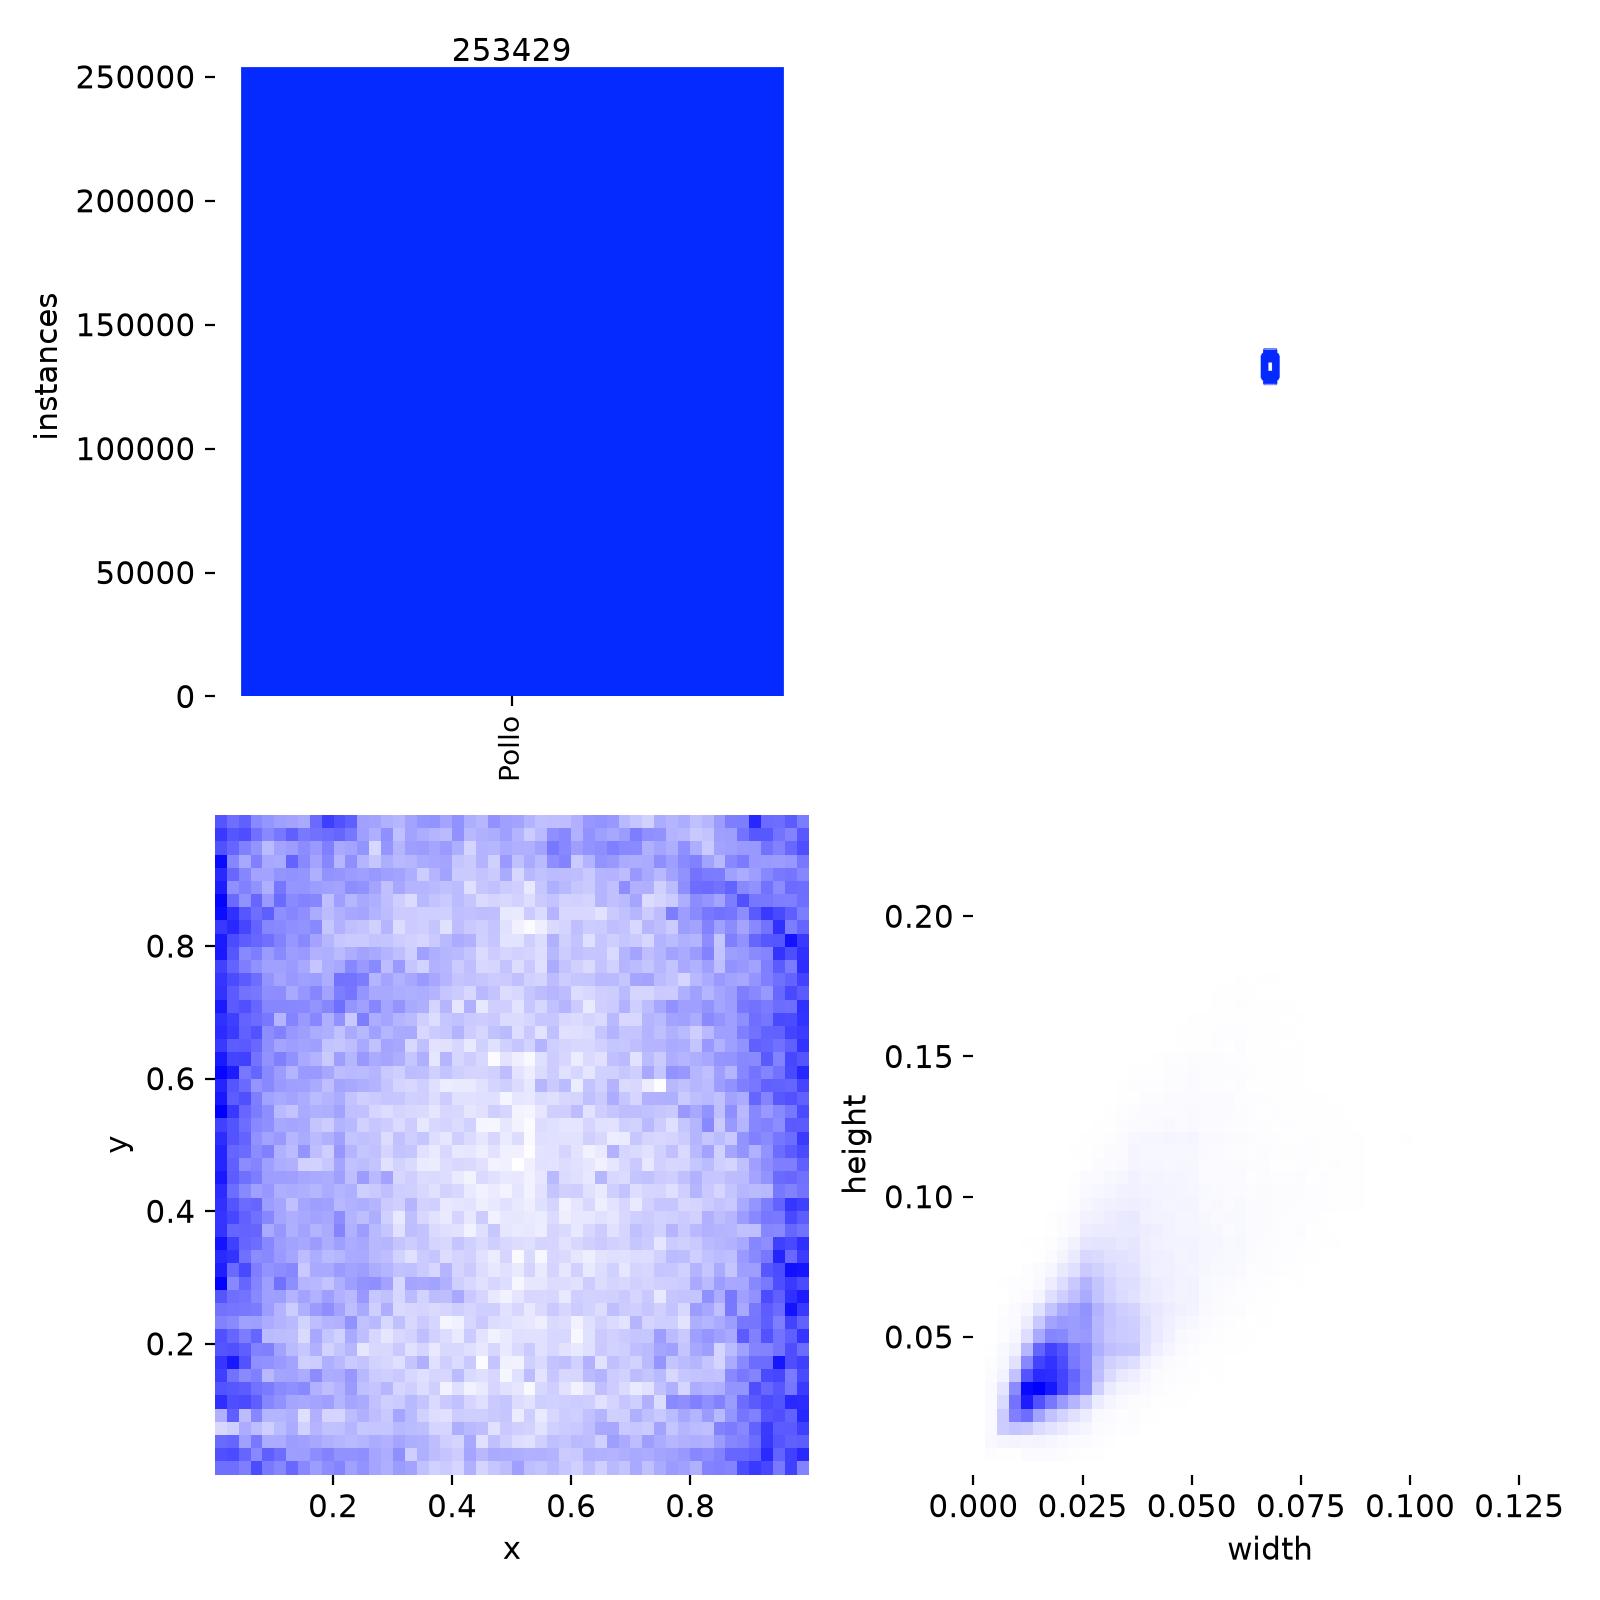
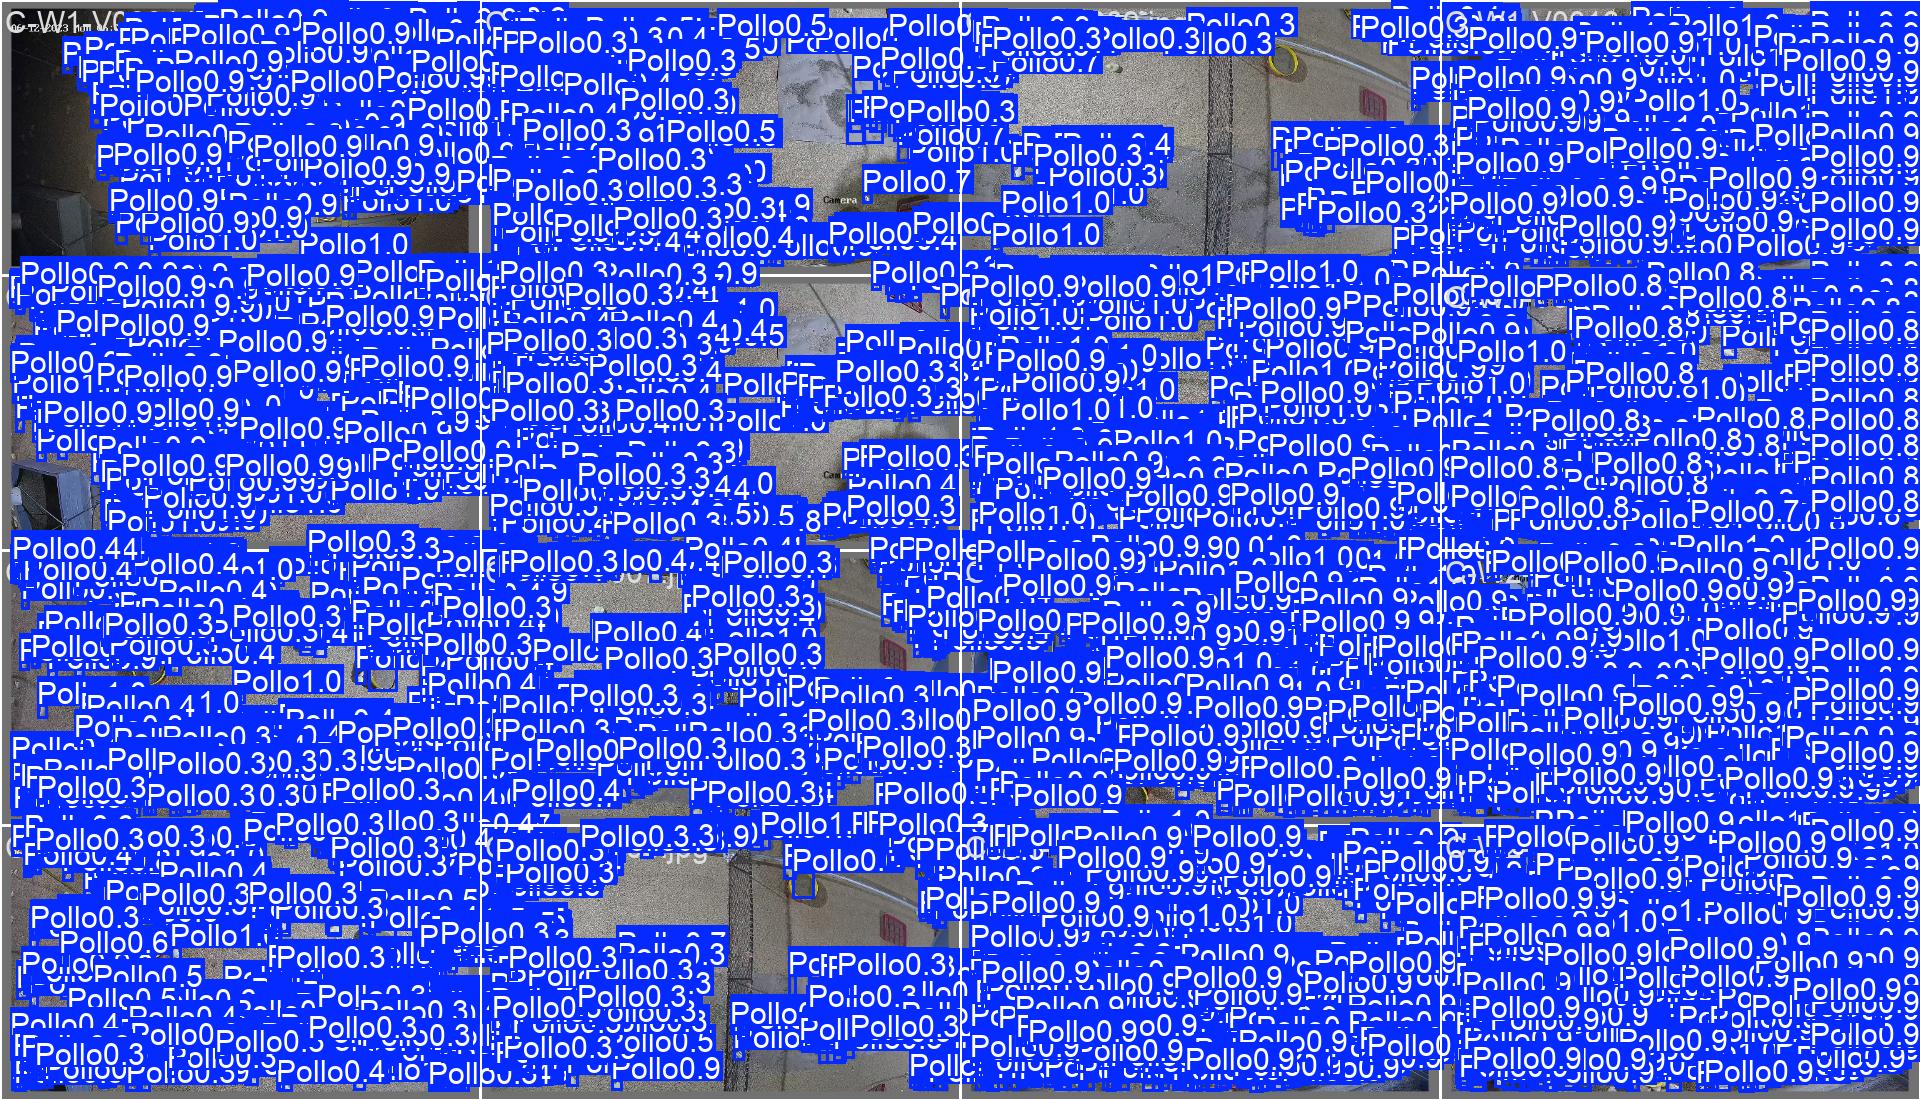
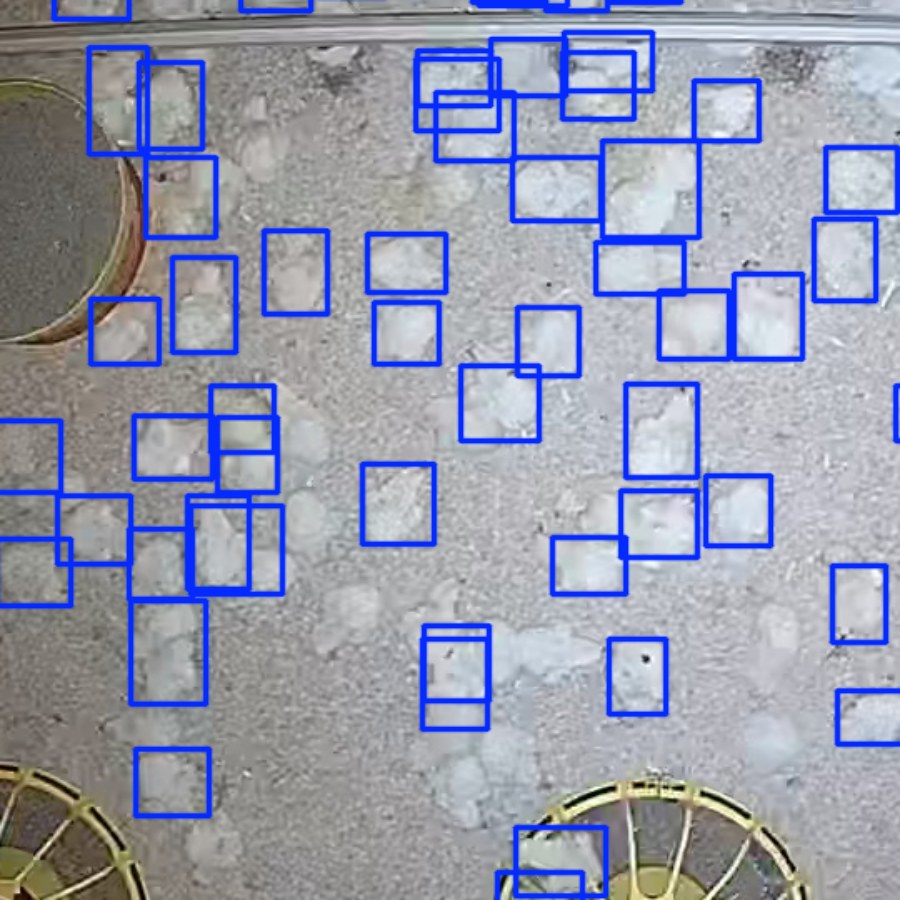
难在哪:多小、多密
这两组数字直接决定显存占用、batch 上限与 max_det 取值——是训练配置的真正依据。
构建自己的数据集:四条原则
- 采集:光照、视角、密度、生长阶段都要覆盖,否则模型只在训练场景里好用。
- 标注:统一 YOLO 格式;多人标注先对齐「框到什么程度算对」。
- 清洗:去重、去模糊/过曝帧,检查越界坐标,别让 classes.txt 混进标注目录被误统计。
- 划分:同批次、同时间段的图整体分到同一边,避免训练/测试泄漏。
02+数据的种类、分类与清洗:我对 PIO 做的一次完整体检本人实测
- 写了体检脚本
J:\poultry\data_audit.py,对 PIO 全部 1,487 张图、327,288 个框逐张检查。 - 按官方命名表
FilePrefixCode.xlsx把数据拆成 鸡舍 × 周龄 共 13 组,统计每组图片数和标注密度。 - 逐项检查标签质量:缺失、空标签、列数、坐标越界、过小框、重复框,以及
classes.txt混入标注目录。 - 用 MD5 + 感知哈希(dHash)查重,发现训练集与验证集之间存在直接泄漏,还有大量「同图不同标注」。
① 数据有哪些种类
| 维度 | 常见种类 | 本课题的情况 |
|---|---|---|
| 成像模态 | 可见光 RGB、热红外 TIR、深度、多光谱 | PIO 只有 RGB;BClayinghens 是 RGB + TIR 配对 |
| 标注类型 | 分类标签、检测框、分割掩码、关键点 | 检测框(单类别「Pollo」= 鸡) |
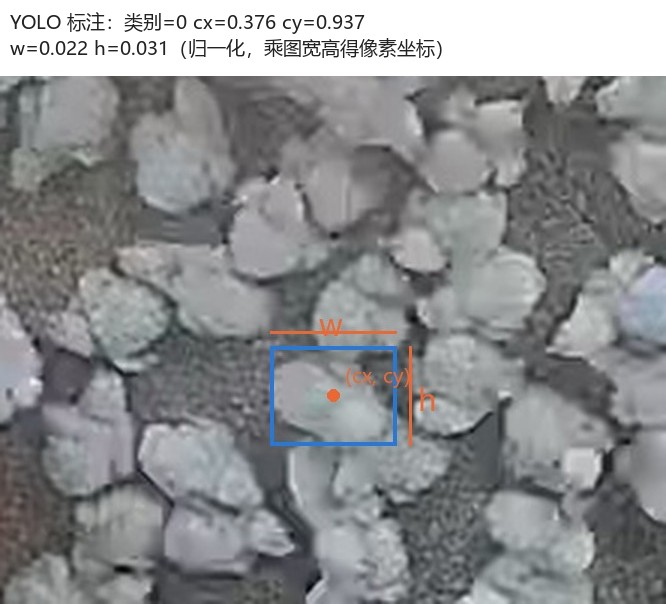
| 标注格式 | YOLO txt、COCO json、VOC xml | YOLO:每行 类别 cx cy w h,坐标按图宽高归一化到 0–1 |
| 数据来源 | 不同场地、设备、时间段 | C = 商业鸡舍,P = 原型鸡舍,W1–W6 = 第几周;另有 19 张 K-* 不在命名表中 |
② 我的分组统计:数据不是均匀的
| 分组 | 训练集 | 验证集 | 平均框/图(训练) |
|---|---|---|---|
| 商业 C-W1 | 145 | 14 | 502 |
| 商业 C-W2 | 200 | 61 | 374 |
| 商业 C-W3 | 119 | 65 | 282 |
| 商业 C-W4 | 110 | 63 | 255 |
| 商业 C-W5 | 14 | 3 | 98 |
| 商业 C-W6 | 149 | 62 | 131 |
| 原型 P-W1 … P-W6 | 81 / 28 / 41 / 81 / 23 / 25 | 49 / 18 / 26 / 64 / 15 / 12 | 78 / 87 / 63 / 46 / 53 / 41 |
| K-*(来源待核实) | 19 | 0 | 308 |
- 密度随周龄下降:商业鸡舍第 1 周每图约 502 只,第 6 周约 131 只。雏鸡小而挤,是最难的场景。
- 两种鸡舍差距大:商业鸡舍每图密度是原型鸡舍的 3–6 倍,适合分开报告指标。
- C-W5 严重偏少:只有 14 + 3 张,这一组的验证结果基本没有统计意义。
③ 我的清洗检查结果
| 检查项 | 结果 | 处理 |
|---|---|---|
| 图片有无对应标签 / 空标签 | 0 / 0 | 无需处理 |
| 列数错误、坐标越界 | 0 / 0 | 无需处理 |
| 过小框(< 4 px) | 训练 12 个、验证 3 个 | 占比极低,保留,但记录在案 |
标签目录里的 classes.txt | 被当成 1 个标签文件 | 是「1,036 个标签 vs 1,035 张图」的原因,统计时要排除 |
自带 dataset.yaml | 路径写的是作者的 Docker 路径 /app/data | 重写成本机 data.yaml |
| 实际分辨率 | 1920 × 1080 | 论文写 1,920 × 1,088,以实测为准 |
| 像素完全相同的图片 | 122 组 | 其中 57 组跨训练/验证(验证集 59 张),43 组在训练集内部 |
| 重复图片的标注是否一致 | 112 组不一致 | 同一张图两次标注差到 21 个框(如 C-W2-0027 / 0181:264 vs 243) |
| 感知哈希近重复 | 63 张(≤ 5/256) | 相邻视频帧几乎一样,同一段视频被拆到了训练和验证两边 |
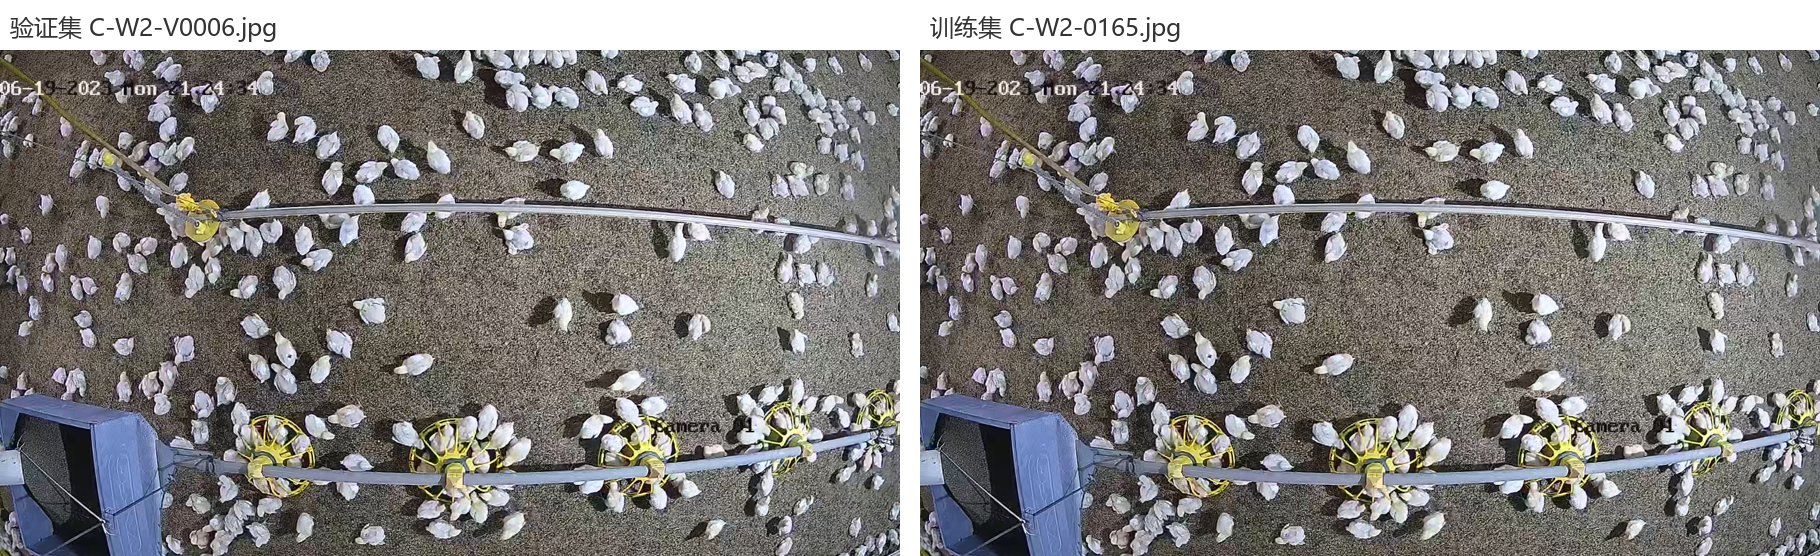
这意味着什么:约 13% 的验证图模型在训练时已经「见过答案」,所以上文 1/3/5 轮以及 25 组基准的验证指标可能偏高。下一步:先去重、统一重复图的标注,再按「同一段视频/同一时间段整体归到同一边」重新划分,然后重跑 5 轮,对比去重前后的 mAP 差多少。
顺带学到的:公开数据集也要自己体检,不能默认它是干净的;划分要按「视频/时间段」分组,而不是按单张图随机分;MD5 只能抓完全相同的图,相邻视频帧要用感知哈希。
想学着这么做:先读 Ultralytics 文档的 Datasets → Detect 了解 YOLO 标注格式 → 自己写几十行脚本统计「图/框/分组」→ 再加查重(hashlib + 感知哈希)→ 有余力再看 FiftyOne、cleanlab 这类数据质量工具。本站 论文写作与方法 第 02–03 节有数据清洗与划分的完整清单。
03技术路线与检测原理
- 单阶段、端到端,符合养殖场「实时连续监测」需求。
- Ultralytics 把不同代际收敛到同一套 API——这是 25 组实验可比的前提。
- n/s 小规格面向边缘设备,大规格面向服务器,可按算力预算选型。
- 选型不能照搬论文:文献高精度多来自常规尺度目标,本课题又小又密,必须实测。
完整推导见 种鸡智能监测 第 05 节。
03+术语与工具:这些名词和脚本是什么、怎么用本人实测
上面几节里出现了不少专有名词和脚本名字,这里统一摊开讲清楚——既是给自己留的备忘,也是「我的什么能给别人用」的具体清单。
① 数据集里的术语
| 术语 | 意思 | 出现在哪 |
|---|---|---|
| RGB / TIR | 可见光相机 / 热红外相机。TIR 拍的是温度分布,不是可见光图像 | BClayinghens 双模态 |
| YOLO 格式标注 | 每行一个框:类别 cx cy w h,后四个数按图片宽高归一化到 0–1(不是像素值) | PIO、BClayinghens 的标签 .txt |
| 笼位 / 轮 | BClayinghens 里,巡检机器人沿轨道走一圈算「一轮」采集;「笼位」是蛋鸡笼架上的一个格子 | 数据集对比表 |
| 商业鸡舍 / 原型鸡舍 | PIO 的两个场地:商业 = 真实规模化鸡舍(36 台相机);原型 = 小规模实验场地(4 台相机) | 数据集对比表 |
| Precision / Recall | 查准率:预测出的框里有多少是对的;查全率:真实目标里有多少被找到了 | 基准表、复现记录 |
| mAP@50 / mAP@50-95 | 检测框和真实框重叠达到 50% 就算对,算出的平均精度;后者是 50%–95% 多档取平均,标准更严格,更能反映框画得准不准 | 基准表、1/3/5 轮对比 |
| reg_max / DFL / l1_loss | 框回归用的两种方式:DFL 把框的边界当分布预测,更精细;reg_max=1 时退化成直接回归(l1_loss) | 三个发现 ③ |
| max_det | 单张图最多允许输出的检测框数量,超过这个数的目标会被直接丢弃 | 三个发现 ② |
② 用到的工具,各自是干嘛的
| 工具 | 是什么 | 为什么用它 |
|---|---|---|
| Ultralytics | 把 YOLOv5 / v8 / v9 / v10 和 RT-DETR 统一到同一套 Python 接口和训练流程的框架 | 换模型只改一行代码,25 组实验才能公平对比(见「技术路线」) |
| Anaconda(conda 环境) | Python 环境和包管理器,每个项目一套独立的依赖,互不冲突 | 避免这个项目的 PyTorch/CUDA 版本和别的项目打架 |
| PyCharm | Python 集成开发环境(IDE),带图形化的运行/调试按钮和 conda 环境选择器 | 配好一次环境后,右键就能跑,不用每次手打命令行 |
| CUDA(cu128) | 让 PyTorch 能调用 GPU 算力的驱动库,版本要对应显卡型号 | RTX 50 系显卡必须用 cu128;版本装错会悄悄退回 CPU 跑,慢几十倍还不报错 |
check_dataset.py | 数据集统计脚本:图片数、标签数、类别分布,标出缺标签和格式异常 | 拿到任何新数据集,第一件事先跑它 |
data_audit.py | 我自己写的体检脚本(见「数据清洗」节),比上面那个多查 MD5/感知哈希查重、坐标越界、过小框、训练-验证泄漏 | 专门用来抓「数据集看起来没问题,其实有泄漏」这类隐蔽问题 |
train.py | 训练入口脚本:顶部几行开关改 EPOCHS/BATCH/MODEL,其余直接运行 | 换模型、调轮数不用碰训练逻辑代码 |
③ 怎么上手:从零到跑出一次训练
# 建一个干净的环境(Anaconda Prompt 里执行)
conda create -n poultry python=3.10 -y
conda activate poultry

# 装训练依赖(RTX 50 系显卡必须用 cu128,其他显卡按官网选对应版本)
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu128
pip install ultralytics

# 先体检数据集,确认标签没问题、没有泄漏,再训练
python check_dataset.py
python data_audit.py

# 改 train.py 顶部的 EPOCHS / BATCH / MODEL 这几行开关,然后直接运行
python train.py
完整的 PyCharm + Anaconda 保姆级教程(每一步截图、常见报错速查表、Conda 环境踩坑记录)在 种鸡智能监测 第 07–08 节,这里只摘环境搭建和常用命令。
0425 组模型基准结果公开资料
按 mAP@50 降序,取自各模型 results.csv 自动汇总(200 轮中的最优值)。
这 25 组是 BClayinghens 数据集上的结果,来自资料页已有的汇总表,不是我在本机、在 PIO 上训练的;我自己的训练结果见下方「复现记录」。
| # | 模型 | Precision | Recall | mAP@50 | mAP@50-95 |
|---|---|---|---|---|---|
| 1 | yolov9-m | 0.9597 | 0.9509 | 0.9792 | 0.7274 |
| 2 | yolov9-e | 0.9585 | 0.9573 | 0.9787 | 0.7440 |
| 3 | yolov9-c | 0.9596 | 0.9554 | 0.9781 | 0.7395 |
| 4 | yolov8-m | 0.9647 | 0.9489 | 0.9771 | 0.7677 |
| 5 | yolov5-m | 0.9627 | 0.9513 | 0.9759 | 0.7262 |
| … | 其余 20 组(含 RT-DETR 三个主干),完整表见 种鸡智能监测 | ||||
| 25 | yolov10-n | 0.9187 | 0.9254 | 0.9594 | 0.6451 |
mAP@50 最优是 yolov9-m(0.9792);mAP@50-95 最高的是 yolov8-x(0.7743)——两个指标的冠军不是同一个模型。
05训练中的三个关键发现本人实测
① batch 受标注密度制约,不只看显存
RTX 5070 Ti(16 GB)上 batch=16 占用 11.5 GB 正常;batch=64 撑到 17.6 GB 崩溃。报错是具有欺骗性的 SystemError: cvtColor,顺异常链挖到底是 numpy 的 ArrayMemoryError。根子在单图平均 220、最高 1,151 个框。
② max_det 默认值会截断召回
框架警告「Dataset images contain up to 594 objects (val=594), but max_det=300」。把 max_det 从 300 改到 600,避免召回被人为压低。
③ 读 best.pt 实测出的结构细节
参数量 2.57M,步长 8/16/32,候选点 8400。reg_max=1:results.csv 表头是 l1_loss 而非 dfl_loss——源码中 use_dfl = reg_max > 1,DFL 分支被移除。还有 E2ELoss 与 one2many + one2one 双检测头,权重按轮数从 0.8:0.2 线性衰减到 0.1:0.9,标签分配用 TaskAlignedAssigner。
06复现流程与记录:我自己训练的数据本人实测
| 训练 | 轮数 | mAP@50 | mAP@50-95 | 耗时 | 日期 |
|---|---|---|---|---|---|
| 冒烟测试 exp_yolo26n_1ep-4 | 1 | 0.645 | 0.291 | 56 s | 2026-09-17 |
| 短训 exp_yolo26n_3ep_b16 | 3 | 0.814 | 0.454 | 89 s | 2026-09-29 |
| 短训 exp_yolo26n_5ep_b16 | 5 | 0.856 | 0.496 | 107 s | 2026-09-29 |
注:验证集约 13% 与训练集重复(见「数据清洗」),以上指标可能偏高,去重后会重跑对比。
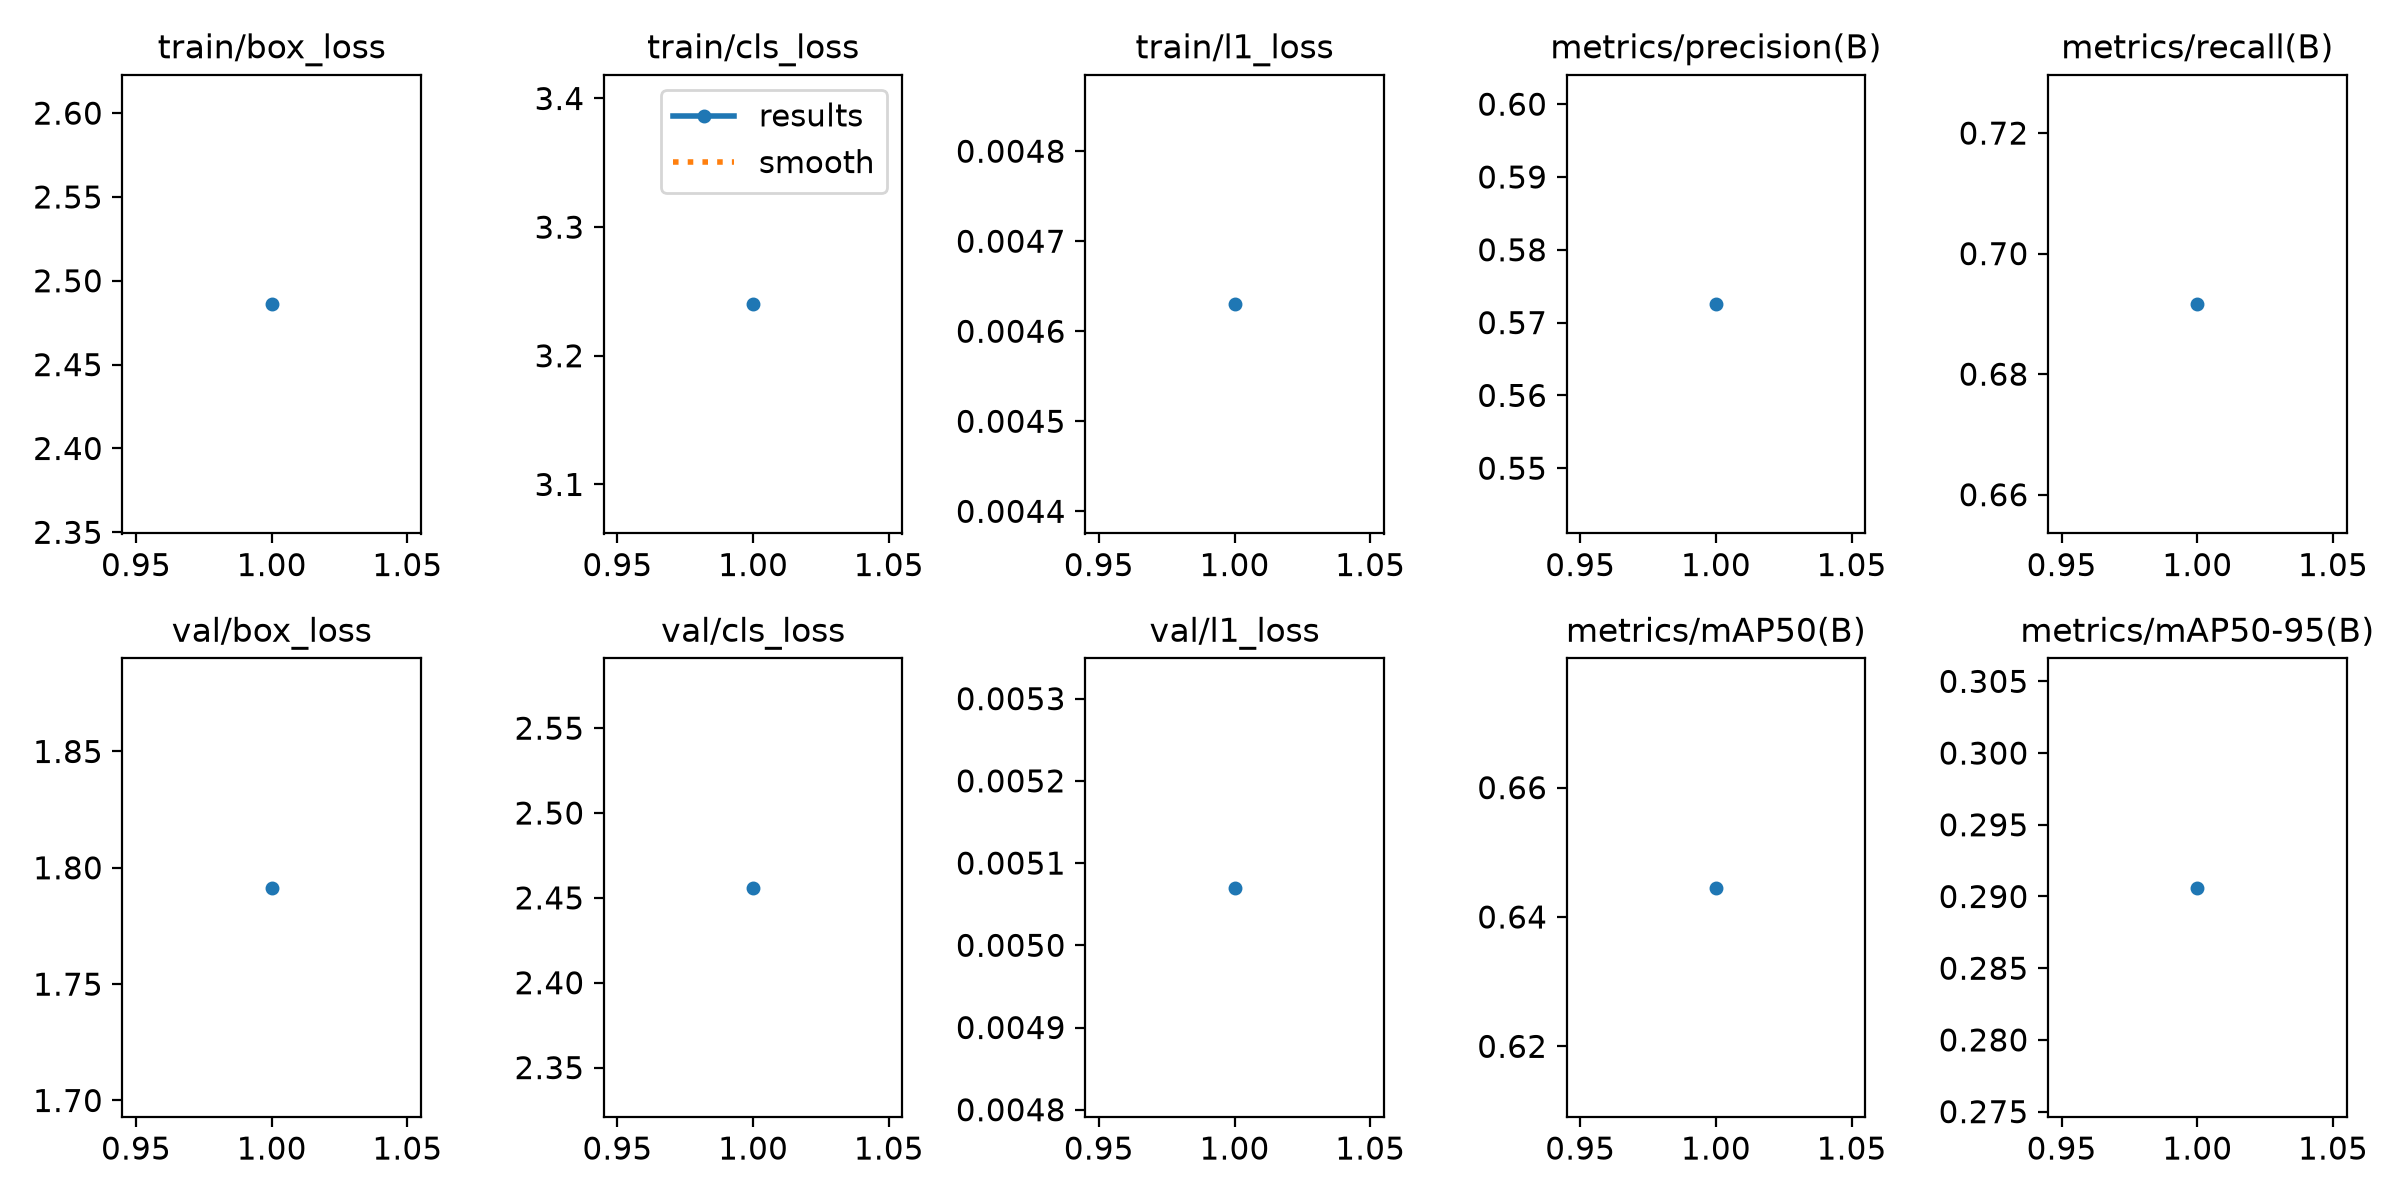
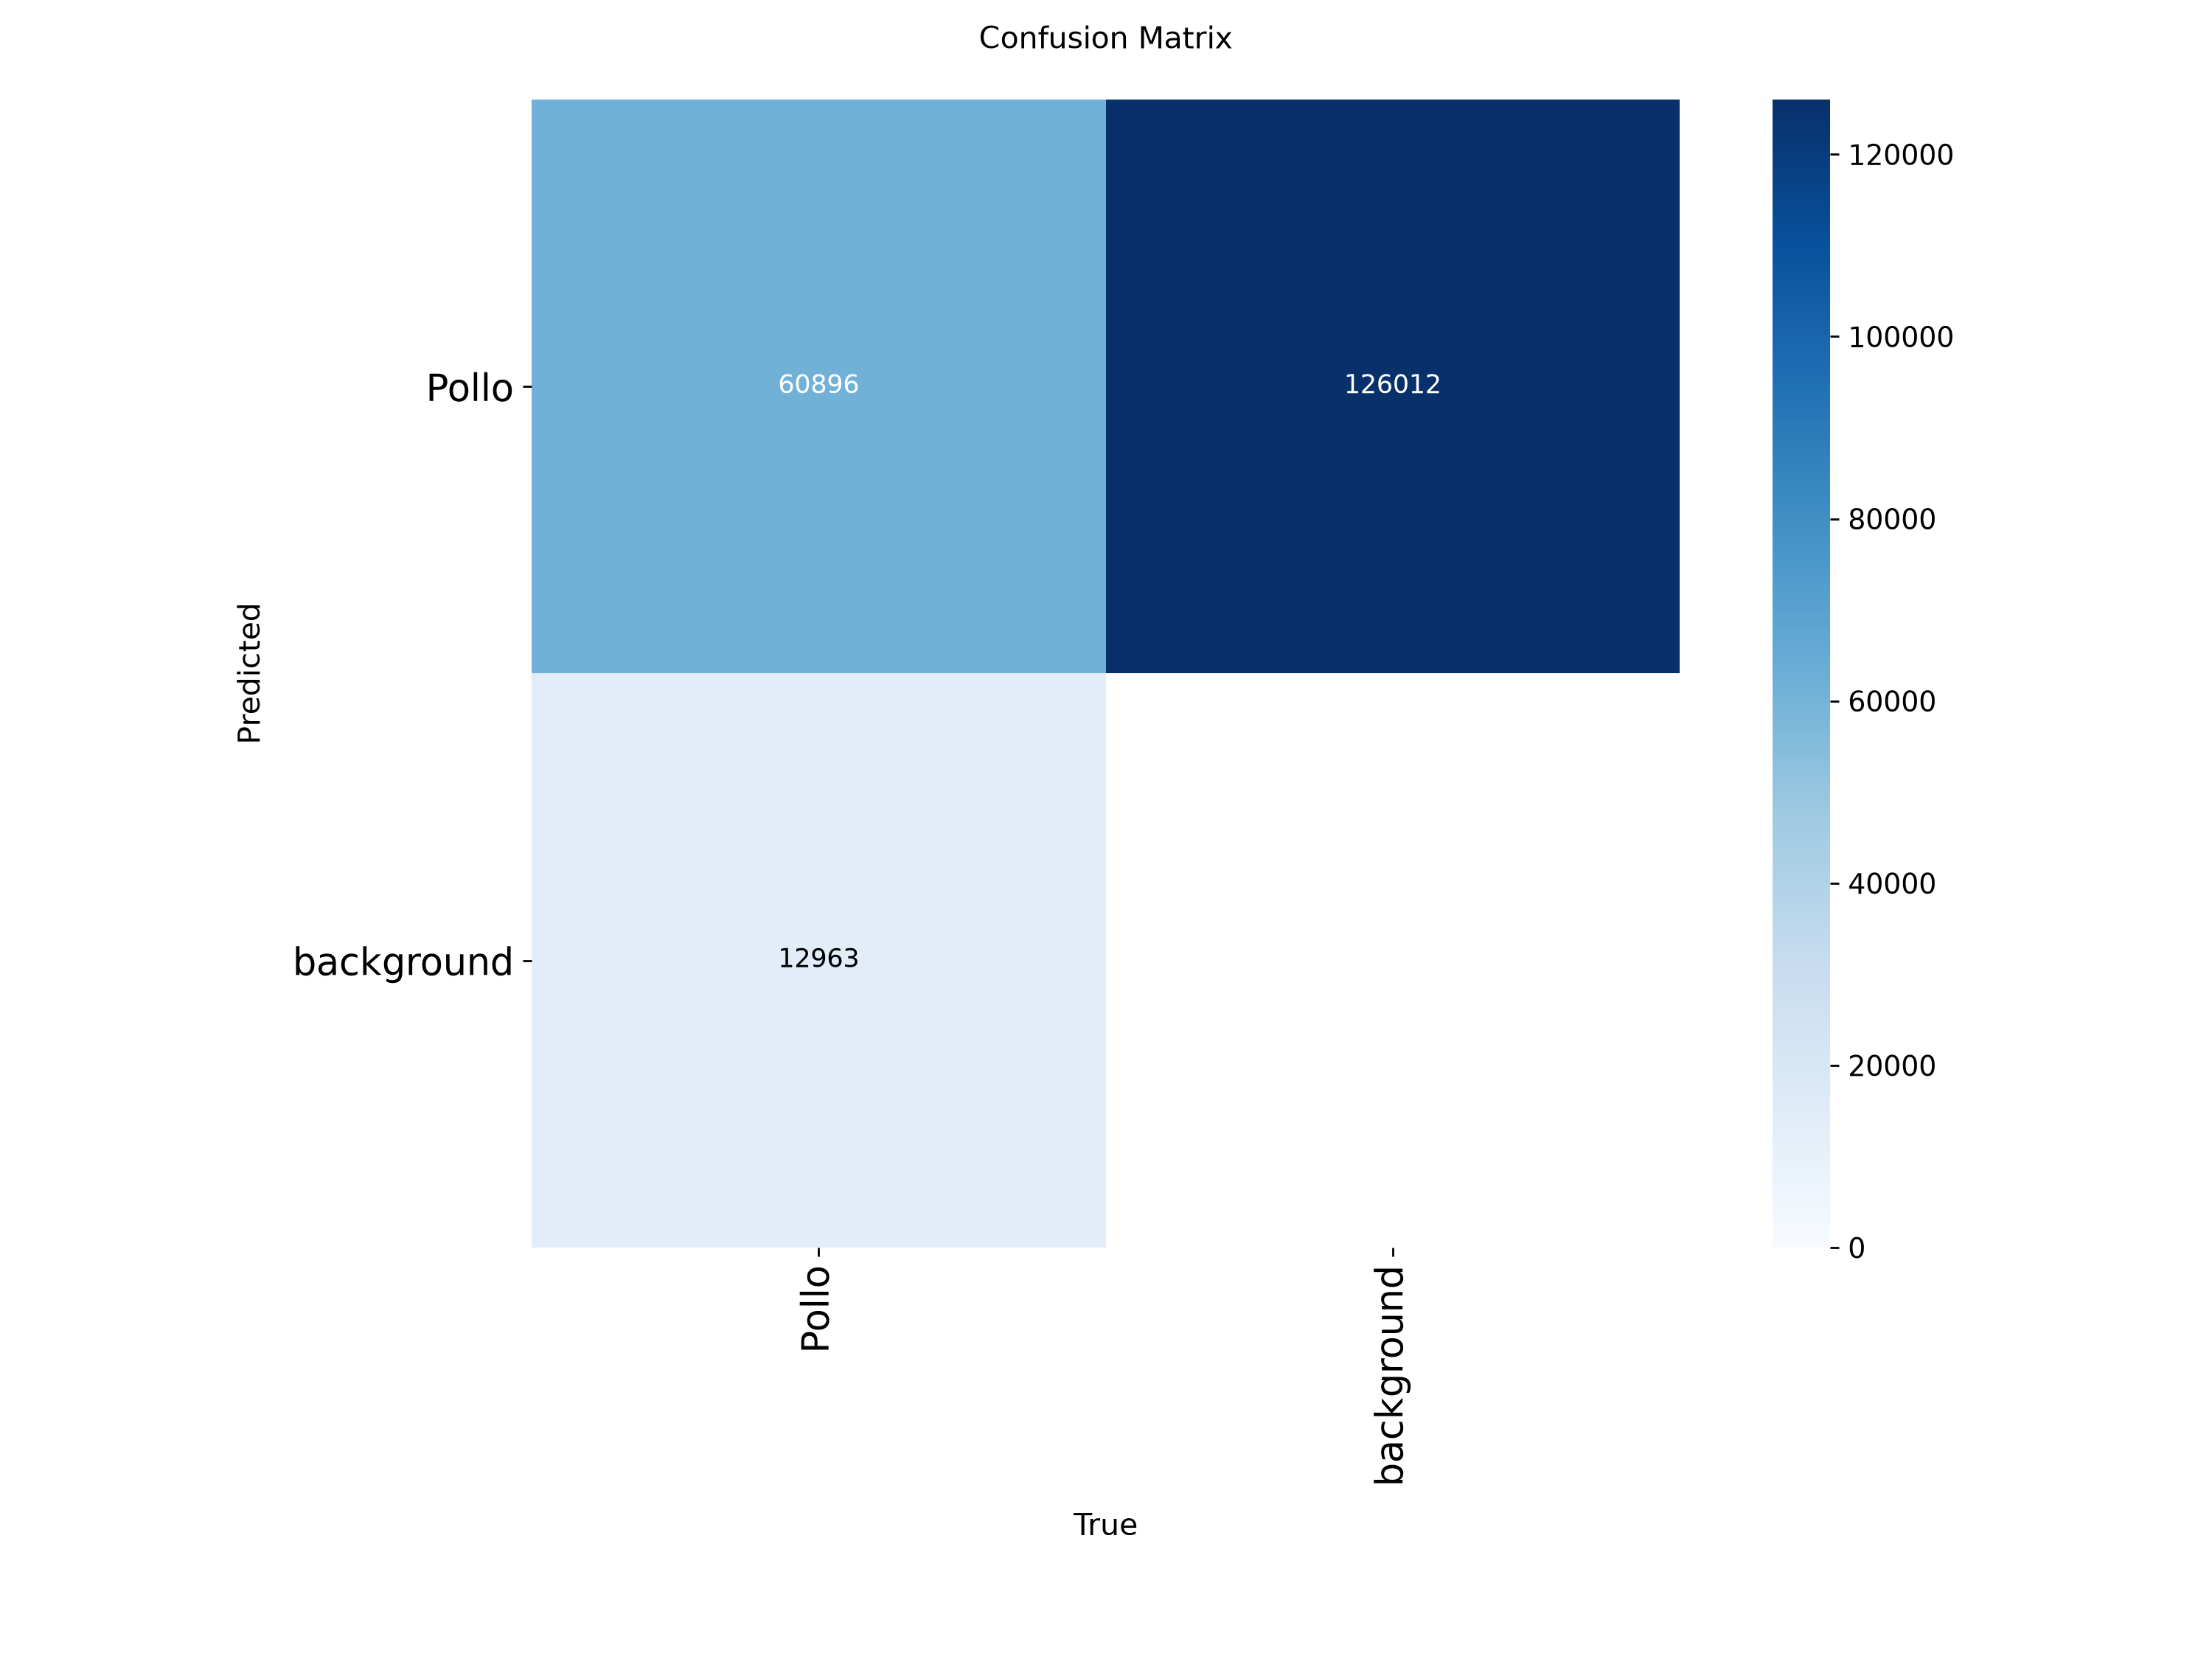
以下均为本机实测:J:\poultry\runs\detect\exp_yolo26n_1ep-4(yolo26n,1 epoch 冒烟测试,2026-09-17),用来验证流程跑得通,不是上面 25 组、200 轮的正式结果,两者不要混着比。
raw/images/train  1,035 张      raw/labels/train  1,036 个(含 classes.txt 误算)
raw/images/val      452 张      raw/labels/val      452 个
yolo26n.pt · cuda:0 · batch=16 · imgsz=640 · max_det=600

Precision 0.5725   Recall 0.6916   mAP@50 0.6445   mAP@50-95 0.2906
单 epoch 55.9 s    box/cls/l1 loss  2.486 / 3.240 / 0.0046
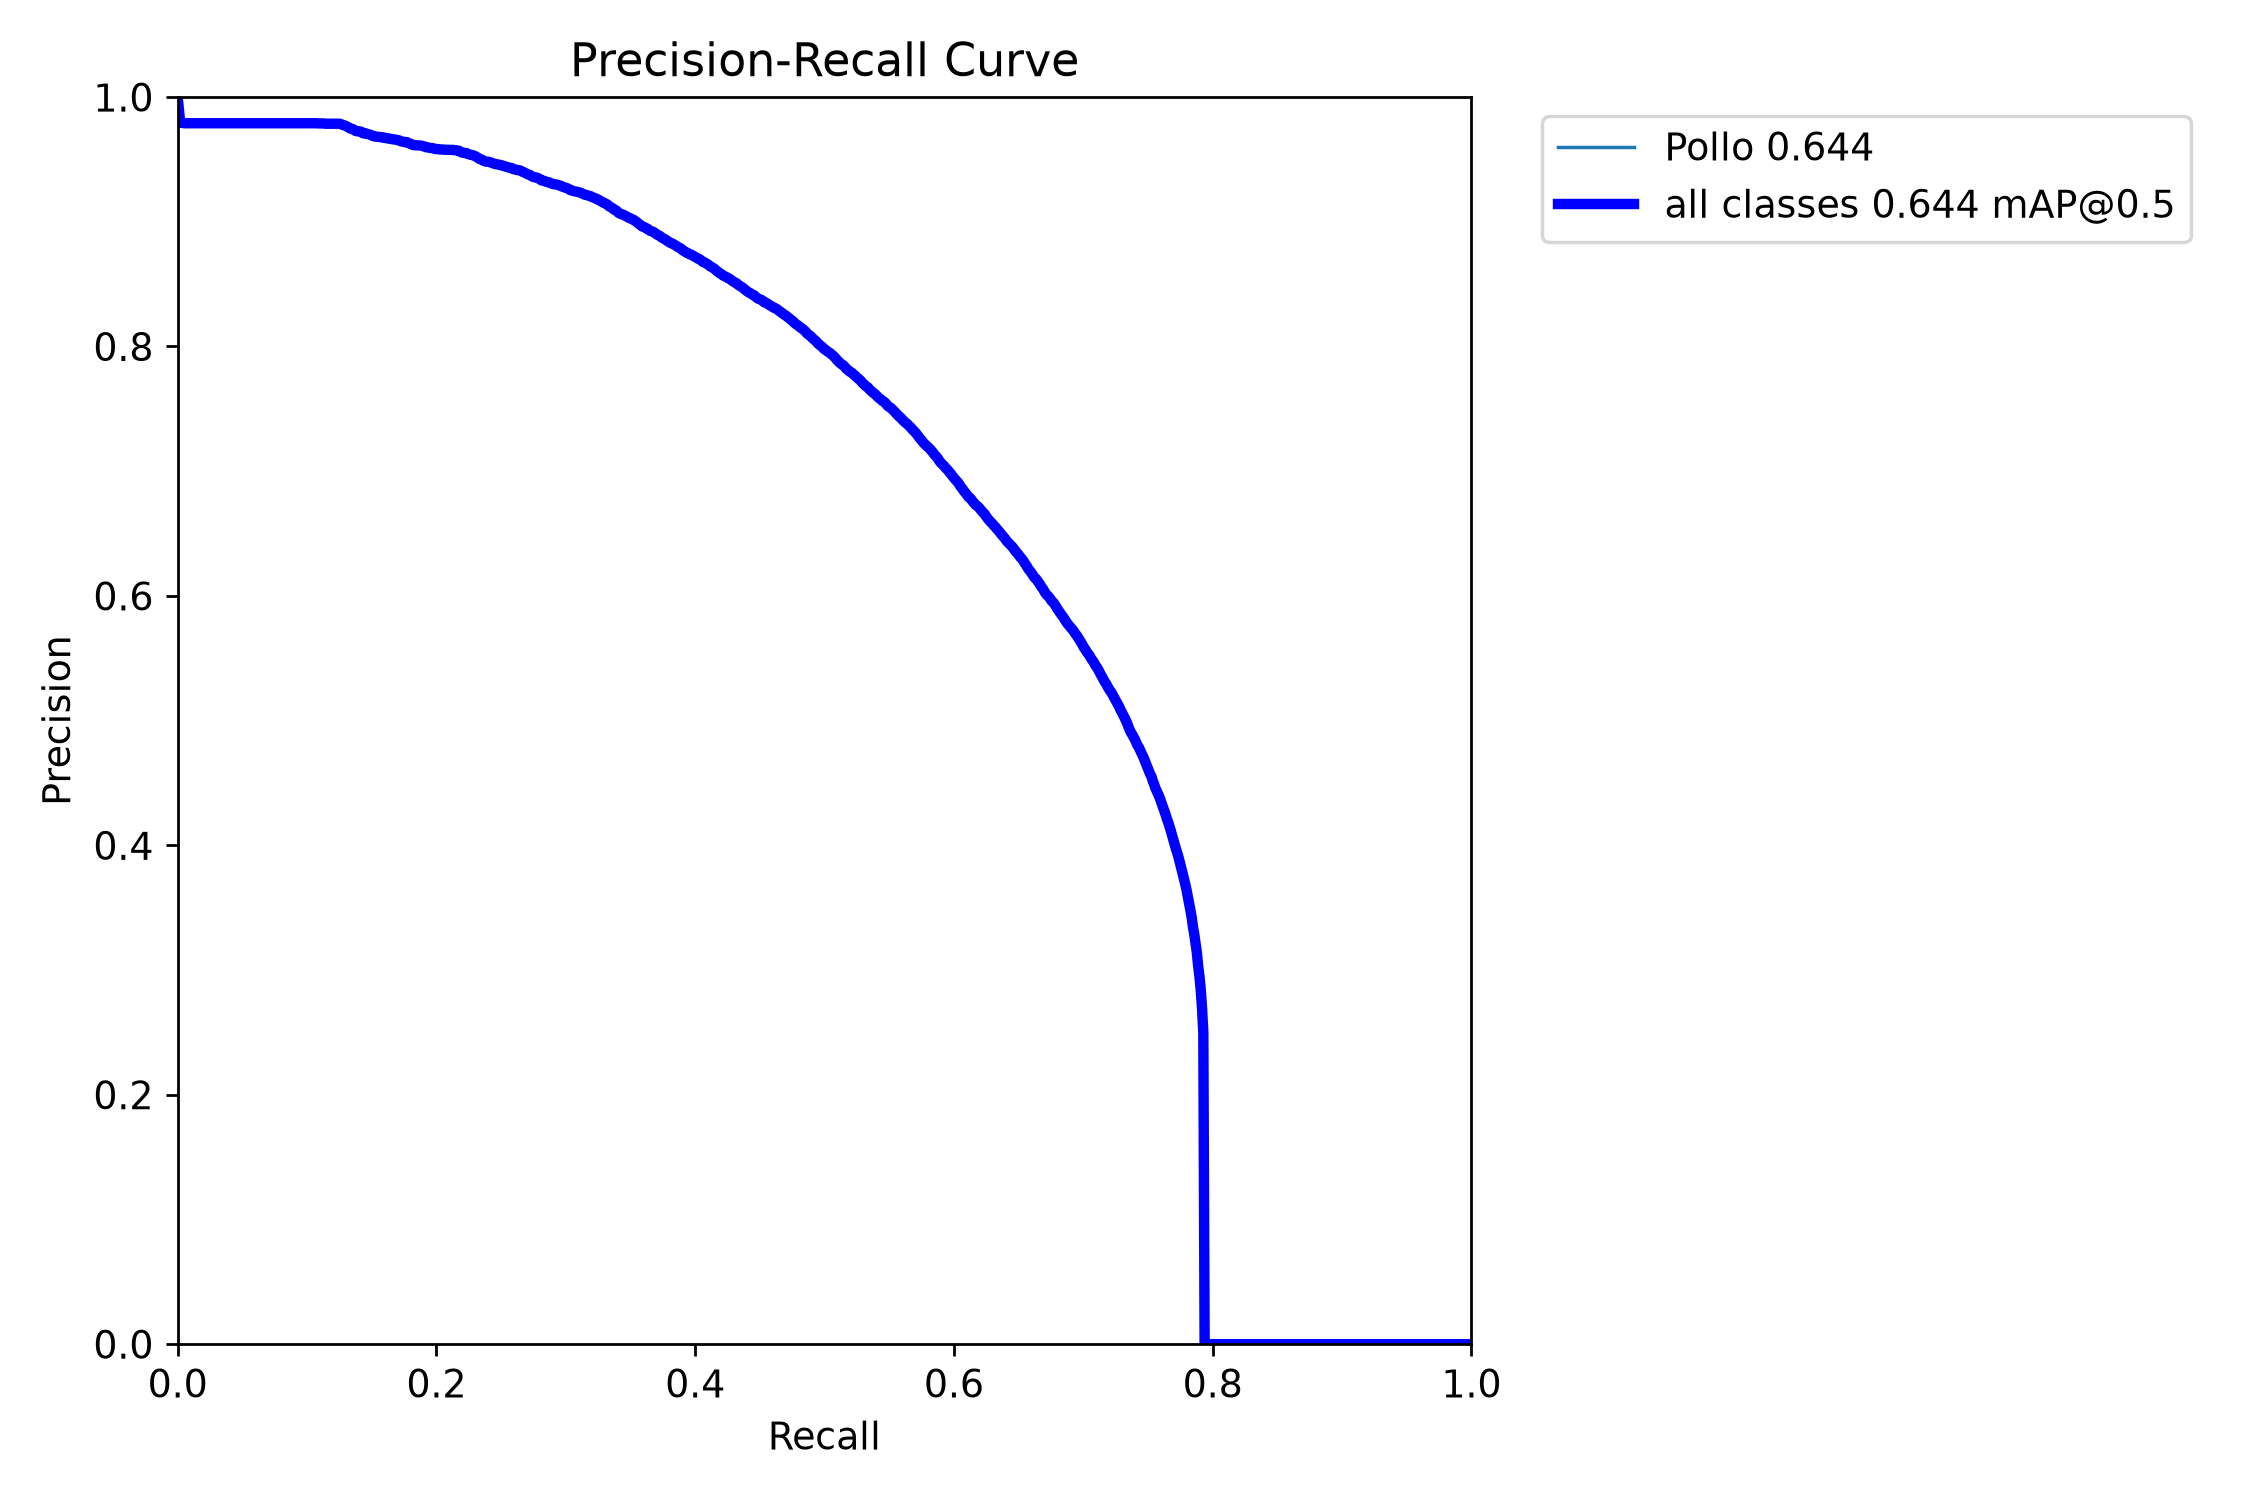
1 / 3 / 5 轮短训对比本人实测
同一配置(yolo26n · batch=16 · imgsz=640 · max_det=600)只改轮数。前 5 轮 mAP@50 从 0.645 升到 0.856;首轮约 34 s(含缓存与预热),之后每轮约 18.4 s,据此估算 200 轮正式训练约 1.0 小时(不含提前停止)。
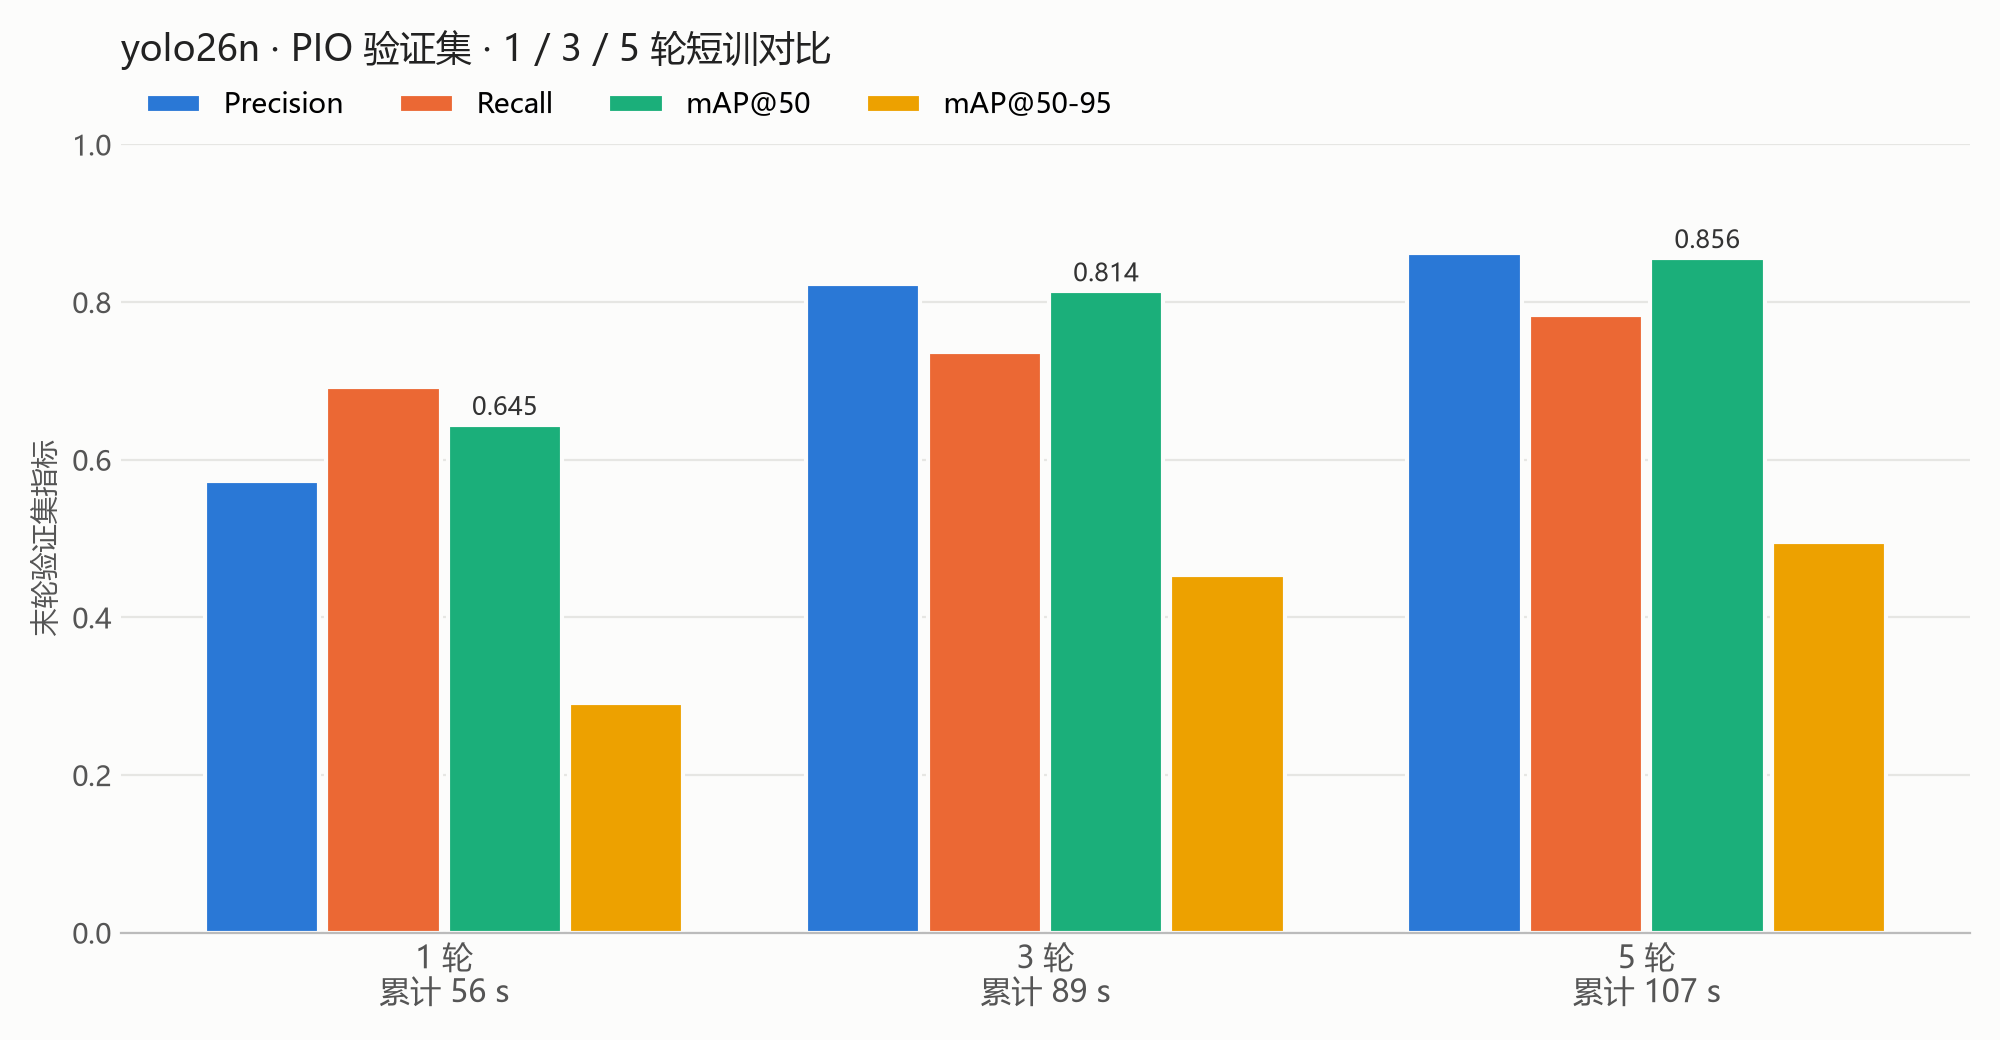
| 指标(末轮) | 1 轮 | 3 轮 | 5 轮 |
|---|---|---|---|
| Precision | 0.573 | 0.823 | 0.862 |
| Recall | 0.692 | 0.737 | 0.783 |
| mAP@50 | 0.645 | 0.814 | 0.856 |
| mAP@50-95 | 0.291 | 0.454 | 0.496 |
| 累计耗时 | 56 s | 89 s | 107 s |
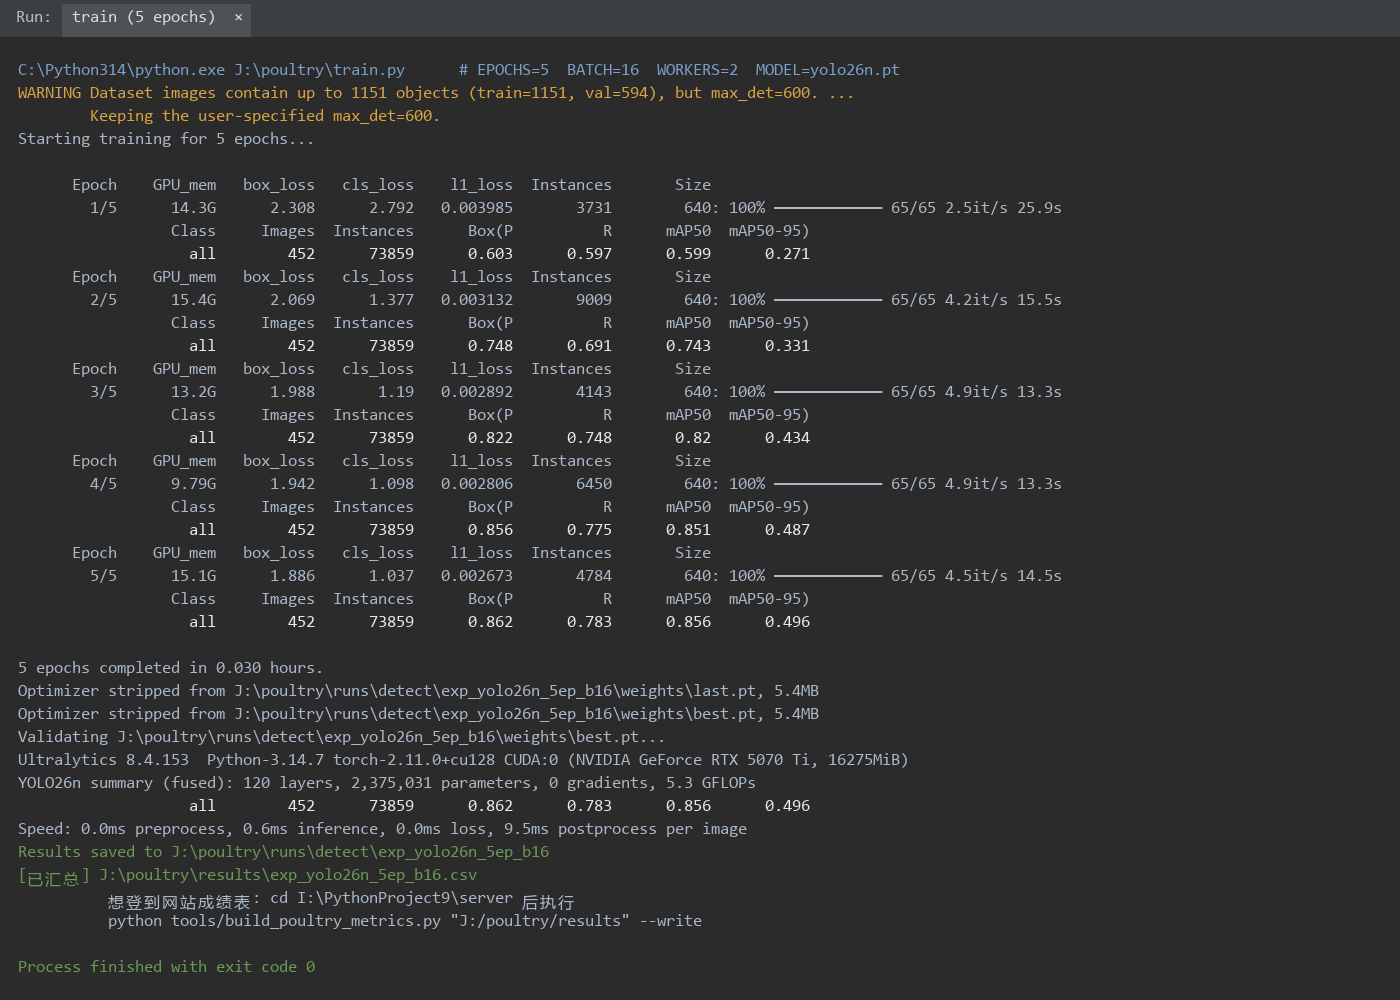
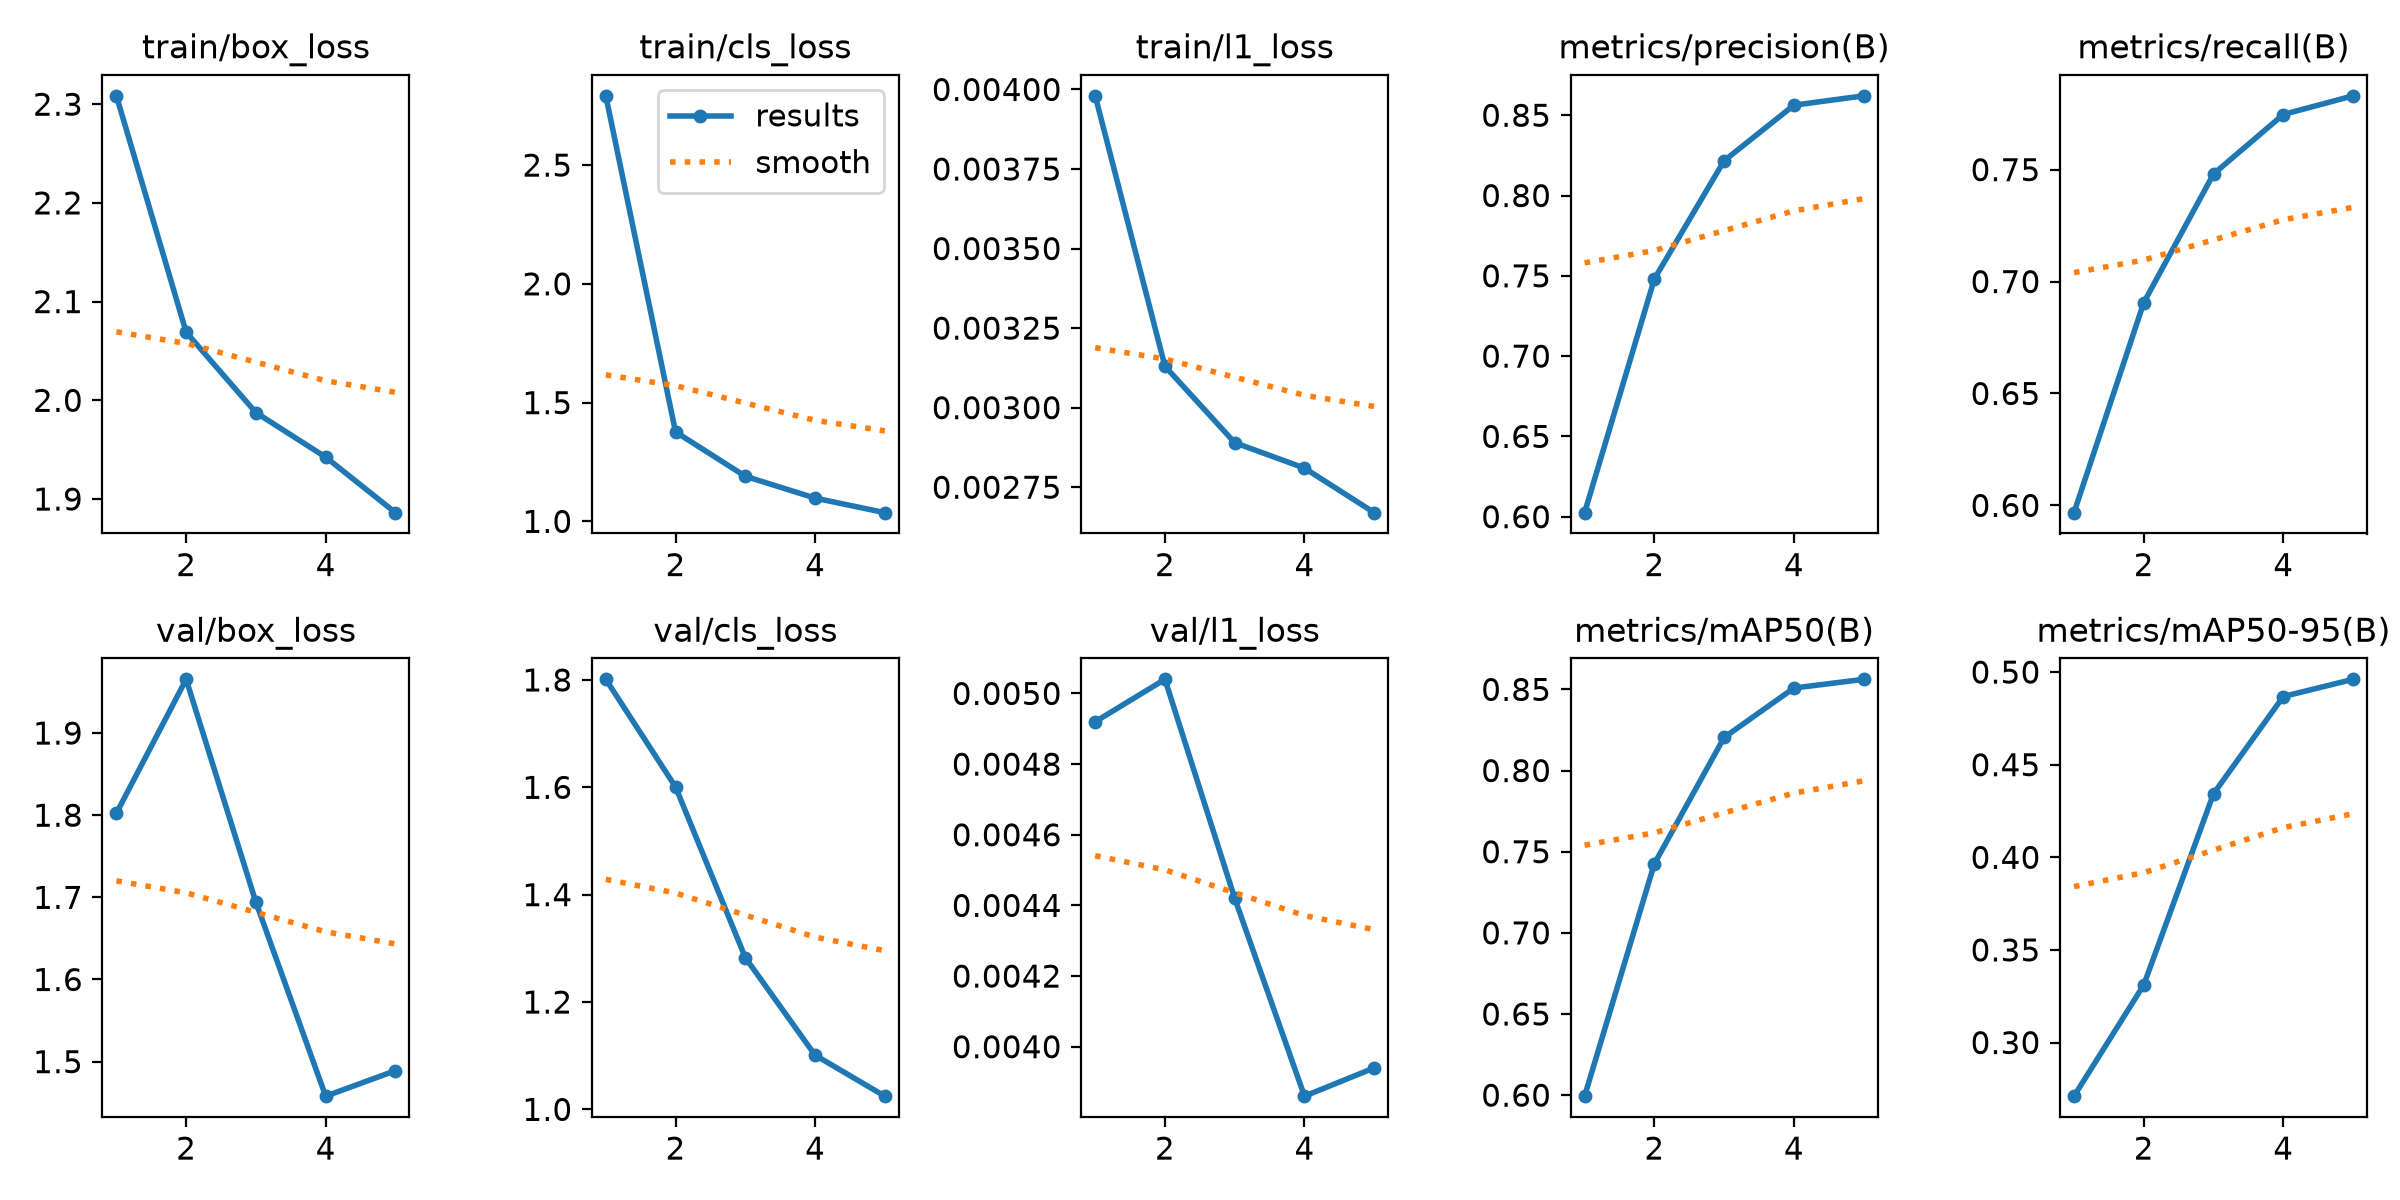
踩坑:WORKERS=4 时两次在第 1 轮中途崩溃(numpy ArrayMemoryError / cv2 Insufficient memory——是内存而不是显存不足:每个数据加载进程都在做 mosaic 拼图,框极密时很吃内存)。降到 WORKERS=2 后正常跑完,该参数不影响训练结果。数据来源:J:\poultry\runs\detect\exp_yolo26n_3ep_b16 与 exp_yolo26n_5ep_b16。
完整训练:143 轮(手动停止)本人实测
在 1/3/5 轮短训基础上,正式跑了一次长训练:yolo26n · batch=16 · imgsz=640 · max_det=600 · workers=0。mAP@50 在 30 轮左右就基本走平,143 轮时精度已很接近收敛,于是手动停止,没有跑满 200 轮。
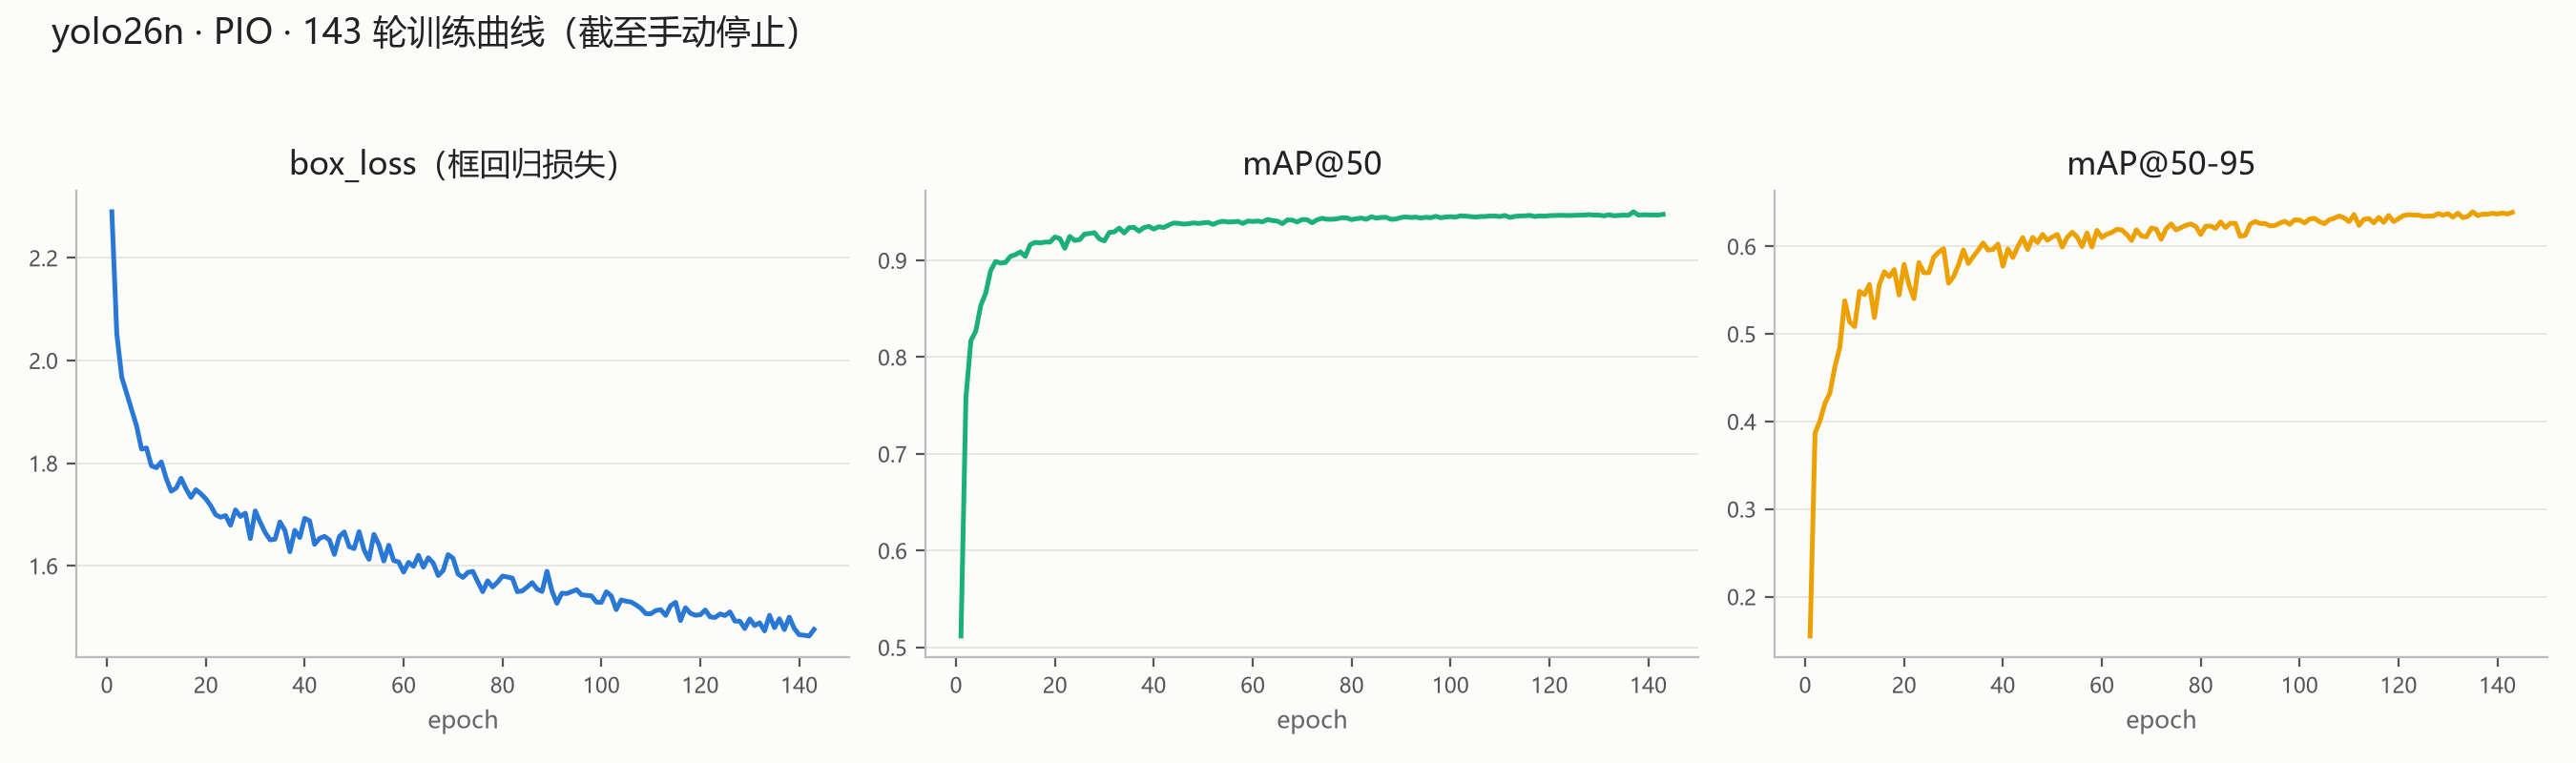
| 指标 | 1 轮 | 3 轮 | 5 轮 | 143 轮 |
|---|---|---|---|---|
| Precision | 0.573 | 0.823 | 0.862 | 0.931 |
| Recall | 0.692 | 0.737 | 0.783 | 0.901 |
| mAP@50 | 0.645 | 0.814 | 0.856 | 0.947 |
| mAP@50-95 | 0.291 | 0.454 | 0.496 | 0.643 |
| 累计耗时 | 56 s | 89 s | 107 s | ≈2.1 h |
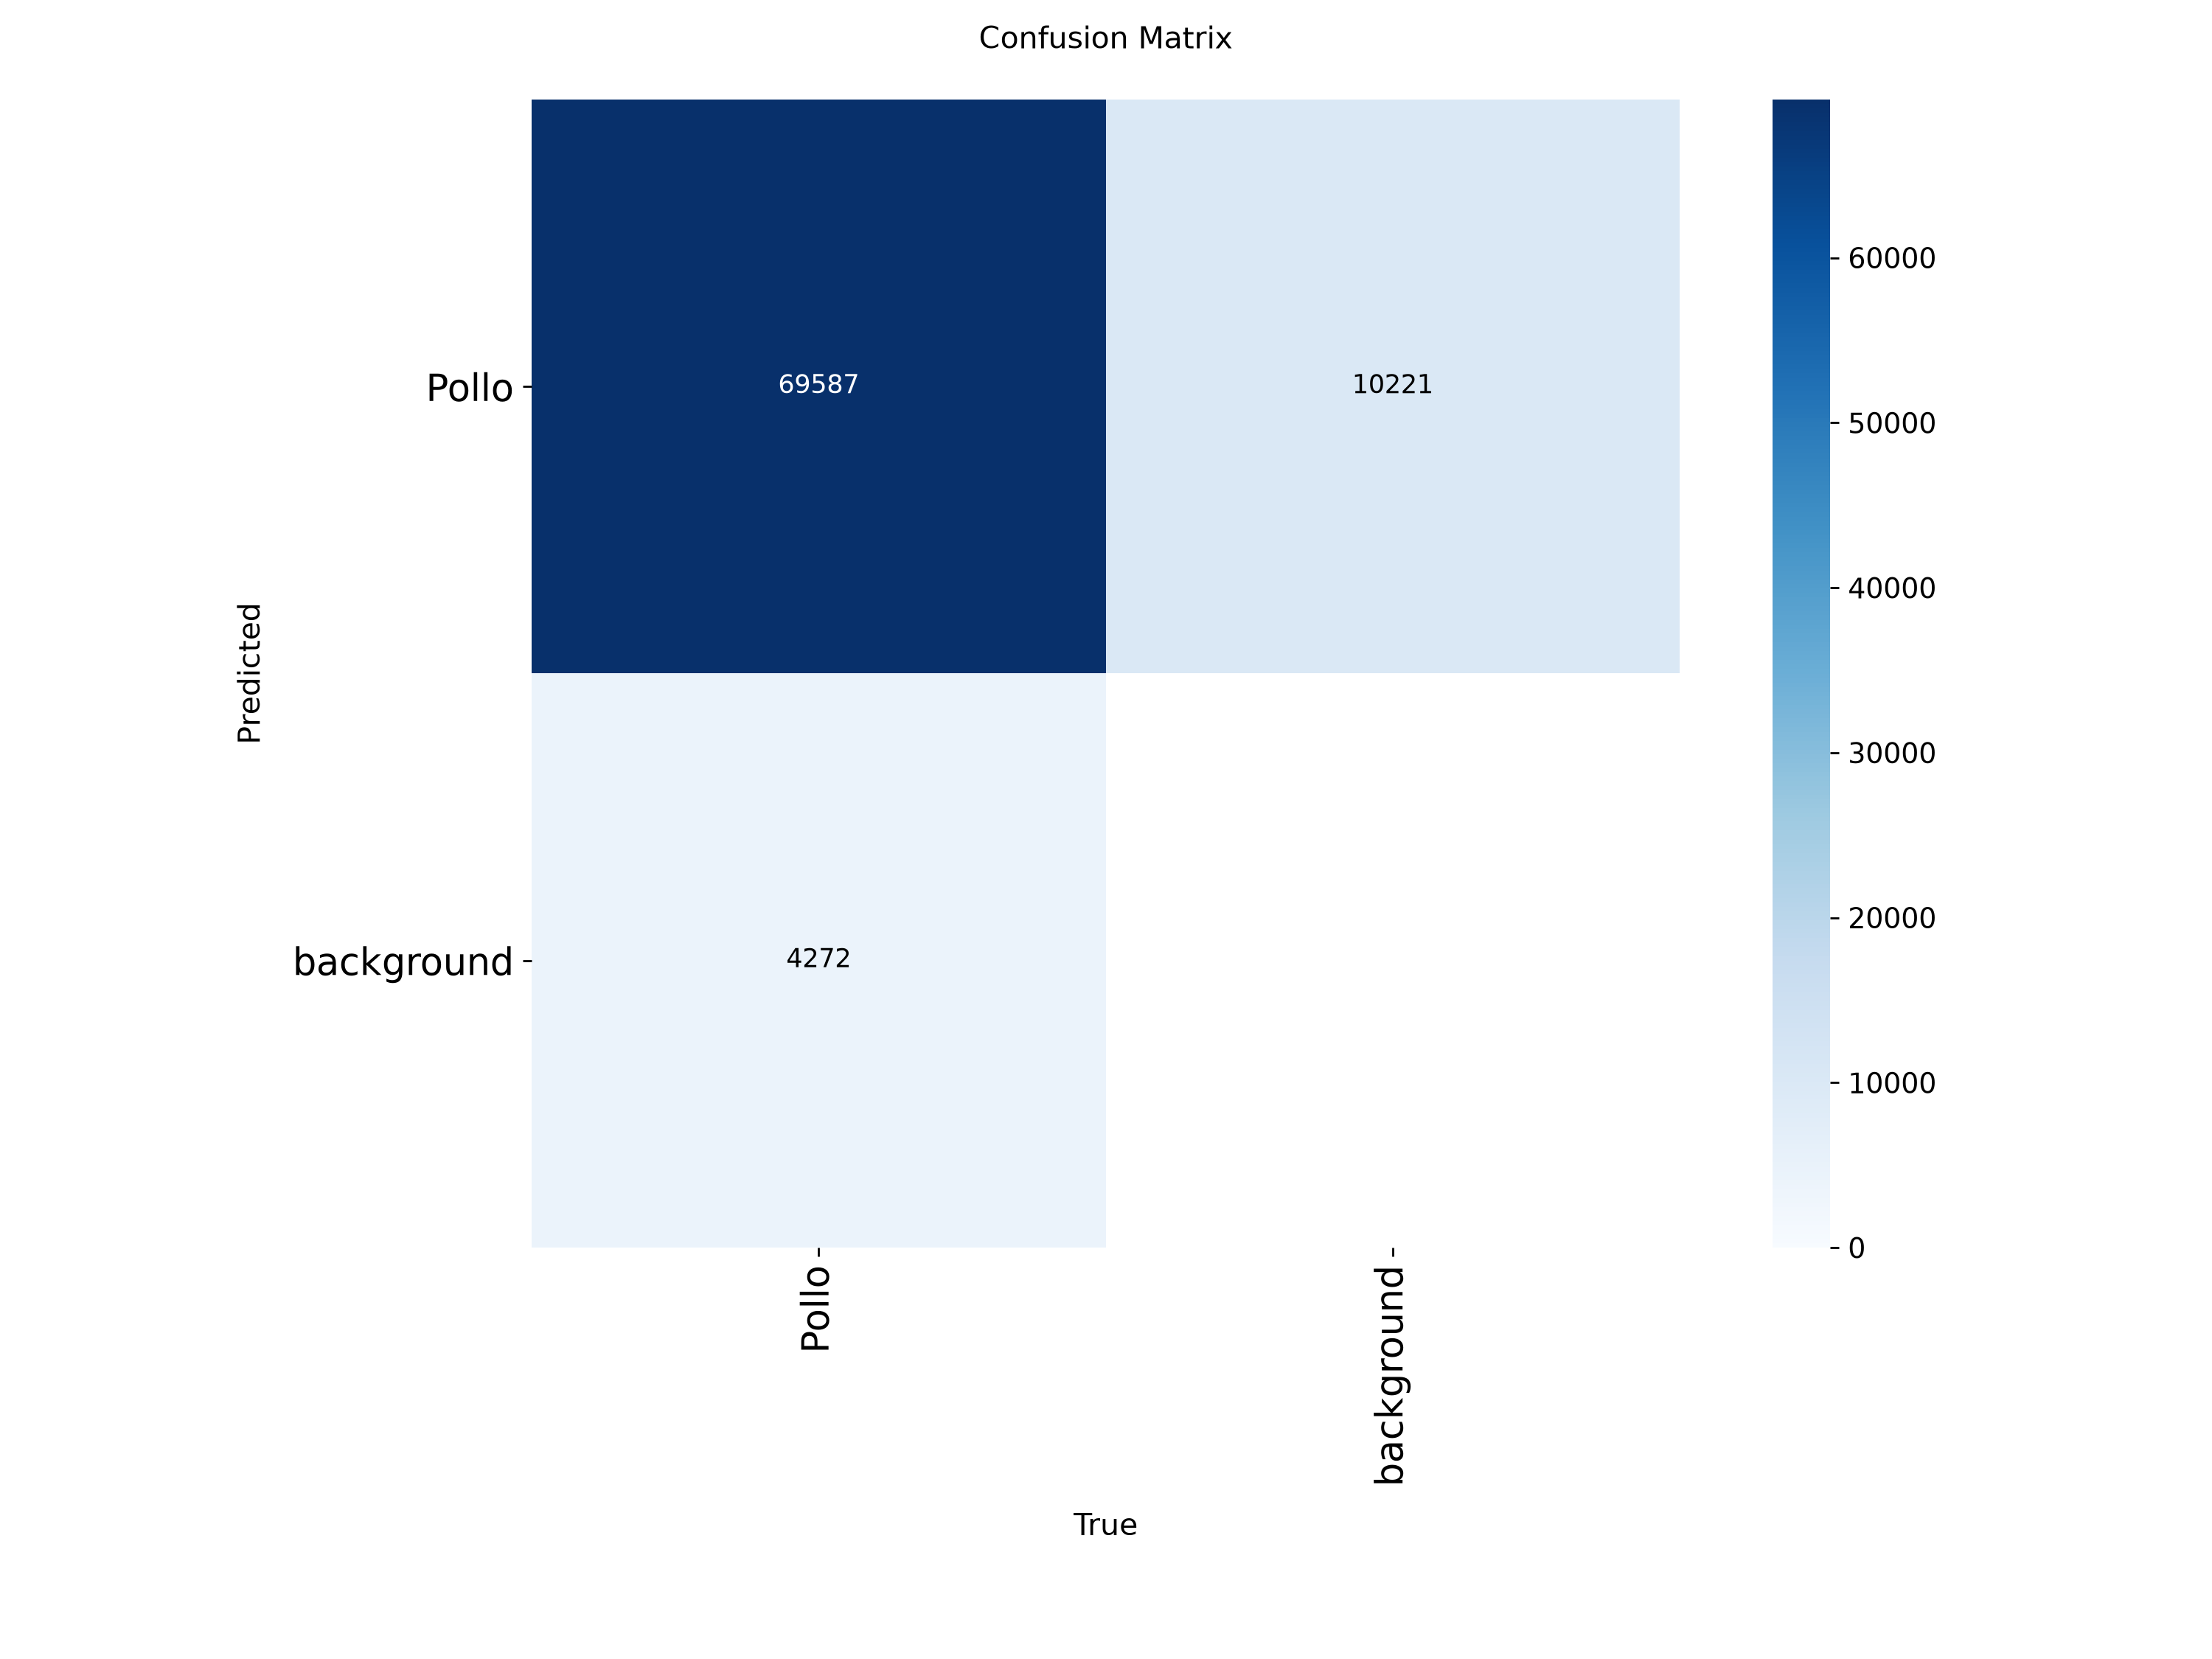
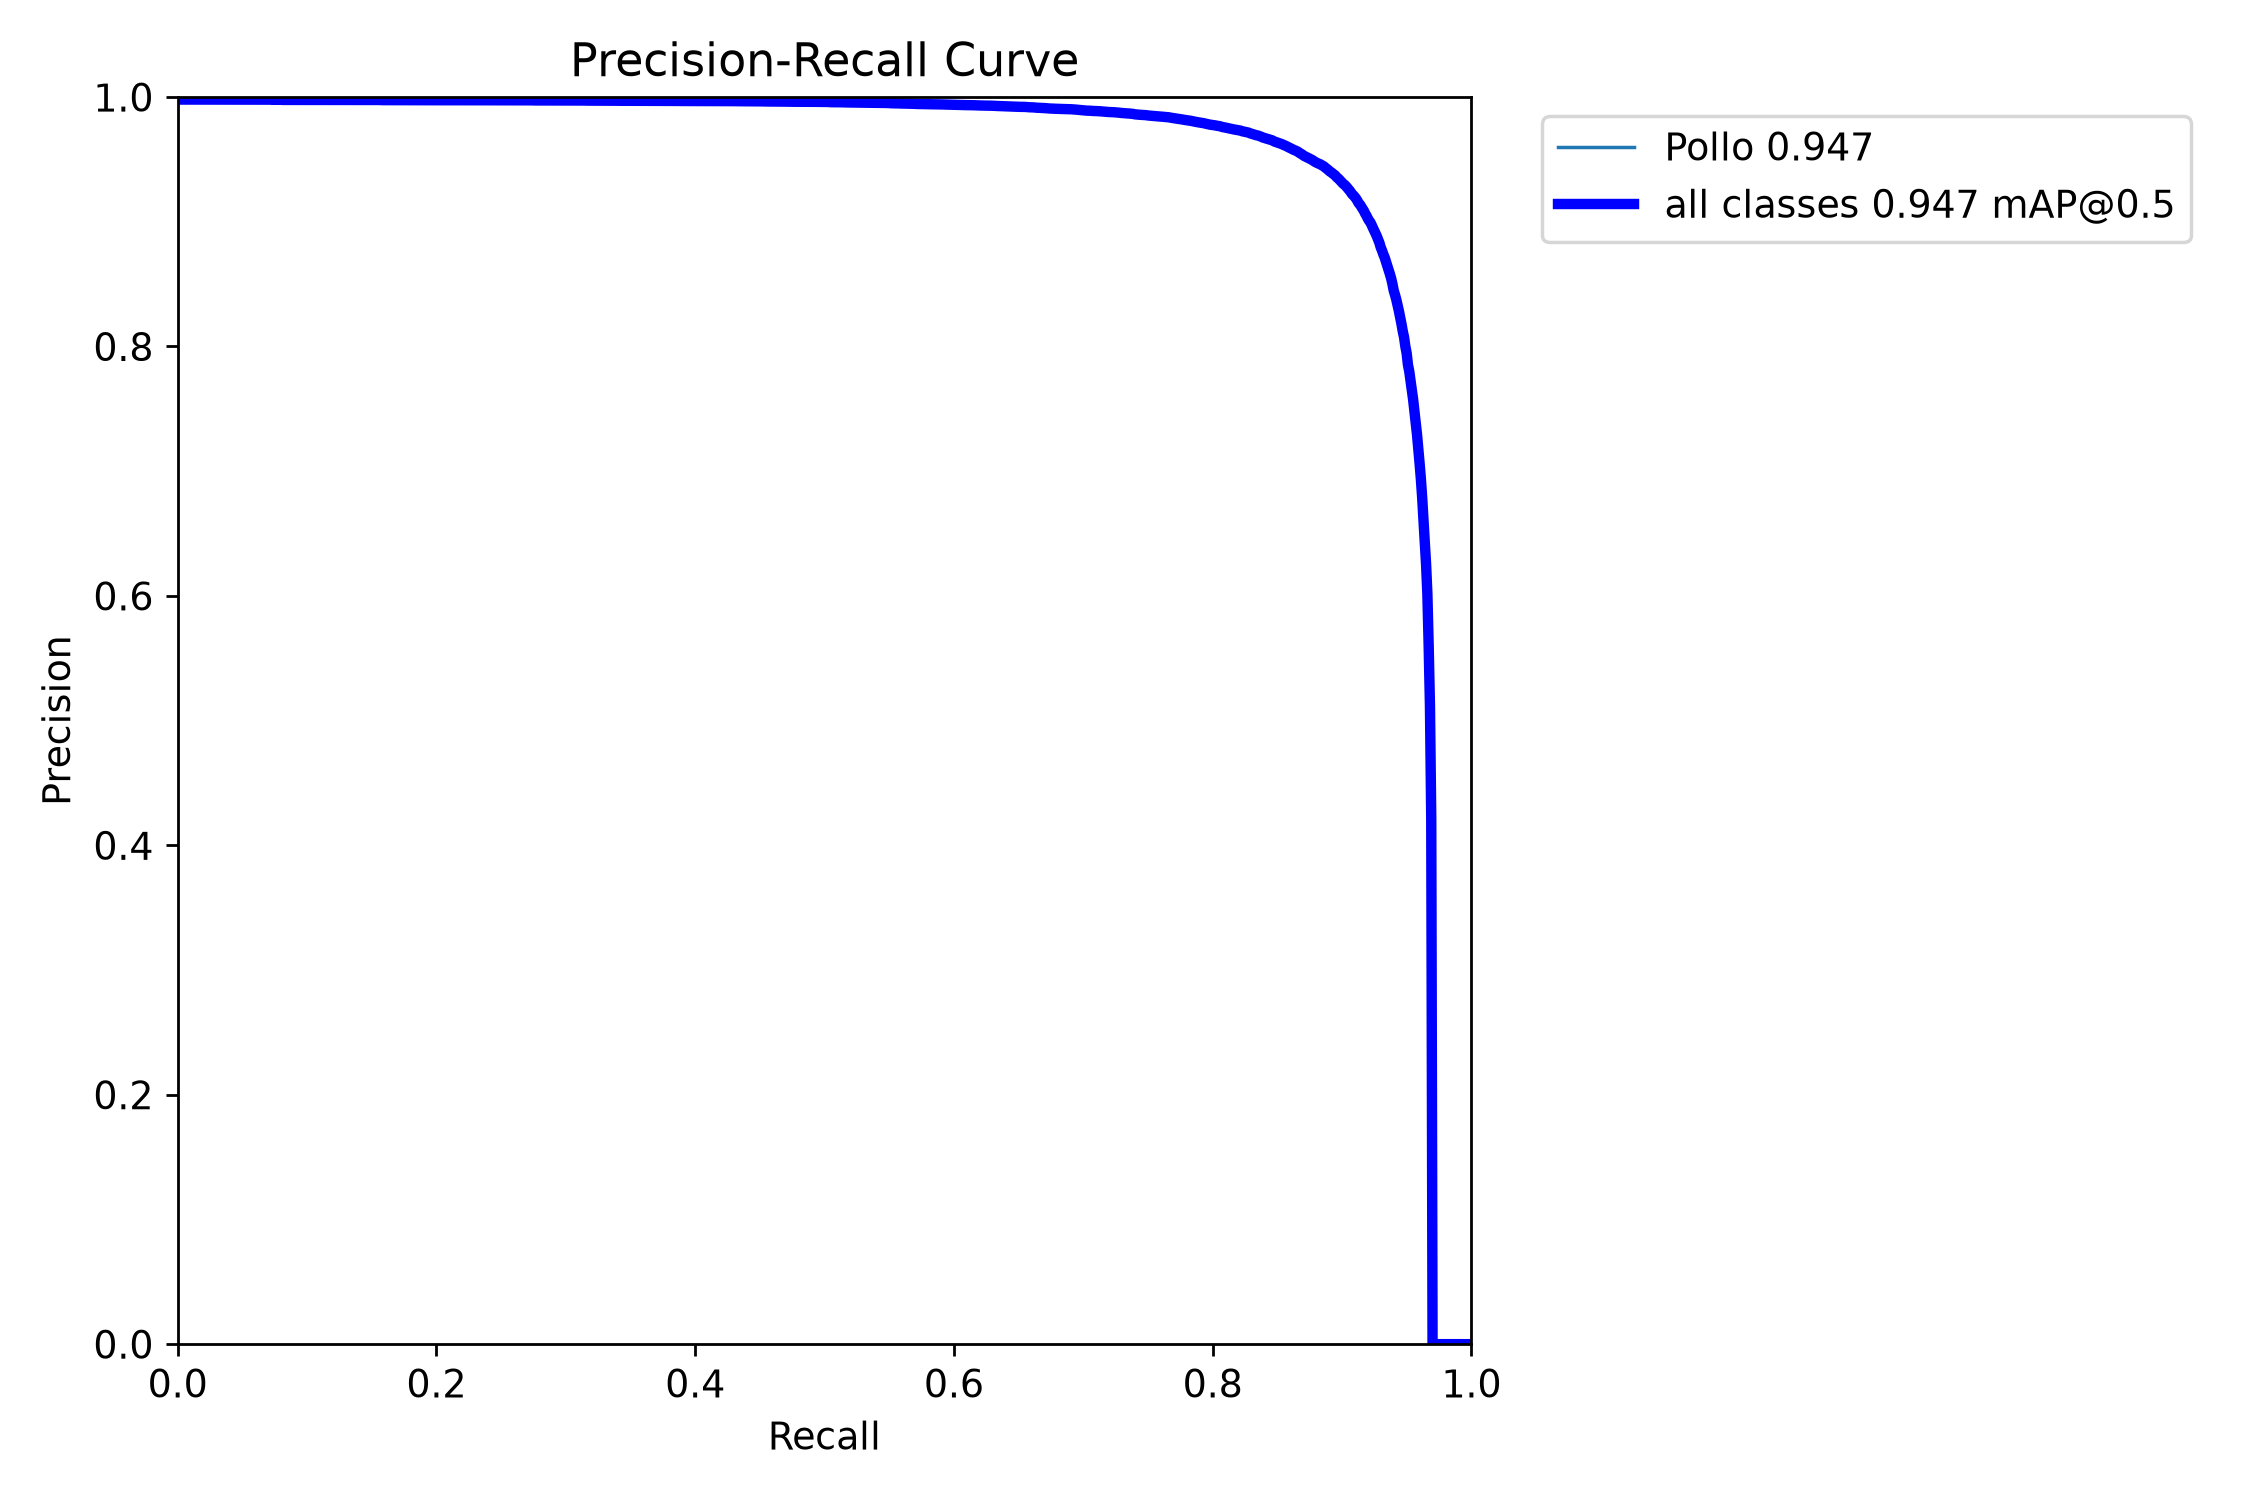
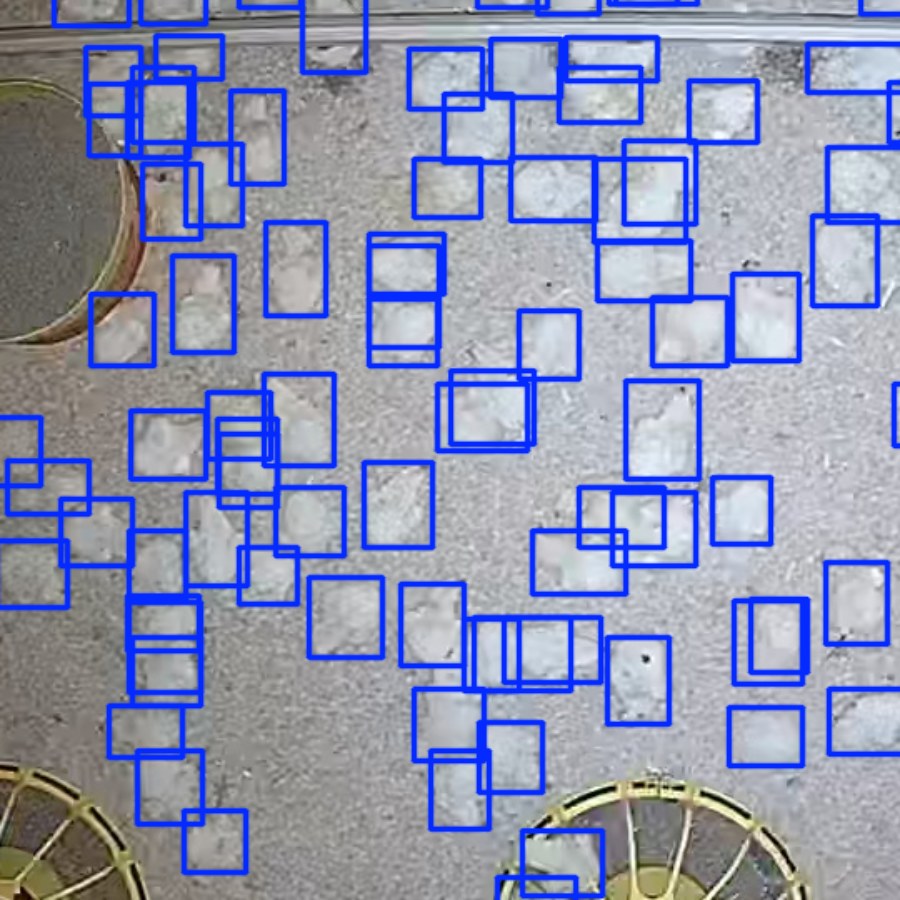
这次真正的踩坑记录:连续崩溃 3 次,报错都是同一个 cv2.error: Insufficient memory,但每次系统还有 14–17 GB 空闲内存——不是真的内存不够,更像是本机 OpenCV 5.0.0 + Python 3.14(非常新的组合)在长时间 mosaic 拼图下偶发的分配失败,分别发生在 WORKERS=4、WORKERS=2、WORKERS=0 三种配置下,说明和 worker 数无关。解决办法不是继续调参,而是写了个自动续训脚本:崩溃后用 resume=True 从 last.pt 接着跑,最终靠这个机制把 3 次崩溃都"渡过去",没有丢失已训练的轮数。数据来源:本机实测,J:\poultry\runs\detect\exp_yolo26n_200ep_b16(2026-09-30 ~ 10-01)。
07论文写作要点
- 数据清洗专门防范数据泄漏;「模型指标 vs 现场/独立数据指标」分开报告,差距要解释。
- 投哪里:看读过的文献发在哪,如 Computers and Electronics in Agriculture。
- 近三年文献一定要读到;参考文献格式统一、英文占比够。
- 消融实验是标配,不是加分项。
详见 论文写作与方法。
08学习路径与下一步
机器学习→视觉概念对照;YOLO 家族演进与改进工具箱;35 条指标与超参名词。
自有养殖场数据独立验证;补全消融实验;扩展到多模态(TIR 温度)。
按目标期刊整理初稿;复现记录补真实截图;规划部署与落地验证。
Collaboration Loop
协同思考:这次汇报能给别人什么、想向别人借什么
① 我做了什么
梳理两套公开家禽数据集,在统一框架下跑完 25 组检测基准,总结出 batch、max_det、reg_max 三个与「小而密目标」强相关的训练发现,并跑通了本机复现流程;对 PIO 做了完整数据体检,发现验证集 13% 与训练集重复、112 组同图不同标注。
② 我的什么可以被其他方向复用
课题组的共识是:一个方法如果只能解决种鸡这一个窄问题,价值有限;能跨动物、跨植物、跨场景迁移,价值才大。按这个标准过一遍:
- 统一框架批量基准:Ultralytics 下换模型只改一行、results.csv 自动汇总——马岗鹅、茶花的检测/分割任务都能直接套用来做选型对比,不用重新搭一遍训练流程。
- 密集小目标的训练配置经验:batch 看标注密度、max_det 按单图最多目标数设——马岗鹅的密集群体场景、茶花的多花朵密集画面都会遇到同样的「又小又密」问题。
- 「读 best.pt / 读源码」核实结构的方法:不照抄教程,写论文方法部分时可直接复用。
- 数据集构建与防泄漏划分的四条原则,以及报错链排查(cvtColor → ArrayMemoryError)的经验:属于课题组要求「尽量共用、不重复造轮子」的数据规范/标注体系这一层,任何方向拿去就能用。
- 数据体检脚本
data_audit.py:任何 YOLO 格式数据集都能直接跑,一次查出缺失、越界、重复与训练/验证泄漏——不挑动物也不挑植物。
③ 我想向其他同学借鉴什么
依据课题组《各课题研究方向之间的关系》:种鸡负责「个体长期监测 + 繁殖性能关联」,马岗鹅负责「开放环境 + 密度变化 + 健康异常」,茶花负责「长时间尺度动态表型 + 智能育种」,农业智能体负责「知识整合 + 工具调用 + 诊断决策闭环」——下面是种鸡方向接下来正好用得上另外三条线成果的地方:
- 向做马岗鹅的同学请教:他们的「检测 + 密度估计」混合框架怎么应对稀疏区与密集区并存——直接对应我们数据里「第 1 周雏鸡挤成一团(单图最高 1,151 只)、第 6 周变稀疏(约 131 只)」这个密度随周龄骤降的问题;他们的个体识别、多目标跟踪方法也是种鸡「阶段一:长期跟踪」最缺的部分。
- 向做茶花的同学请教:他们「动态表型建模、性状评价、优株筛选」这套方法论,本质和种鸡「行为 ↔ 生产性能」是同一类问题——都是把随时间变化的表型(茶花的花期/花色,种鸡的采食/活动)关联到最终的生产/育种价值,他们在时序建模和可解释分析上的经验能直接迁移过来。
- 向做农业智能体的同学提前对齐接口:以后种鸡的检测/行为/预警模型要被智能体调用,完成「数据输入→状态理解→诊断建议」的闭环,需要提前问清楚模型输出要满足什么格式,不要等模型训完才发现接口对不上。
未来方向(见下)里的三阶段路线和上面这三条借鉴需求是同一条主线:把种鸡的「阶段一:个体+跟踪+行为」做扎实,同时留意能不能直接用到马岗鹅/茶花已经跑通的方法。
Next Direction
未来方向:从「看见鸡」到「理解种鸡生产性能」
上面几节做的检测(数鸡、定位)只是起点。种鸡方向真正要交付的,不是再训一个 YOLO 模型,而是把检测结果接到一条长期的关联链条上,最终服务于种鸡精准管理和辅助育种。
检测 · 身份识别 · 长期跟踪→ 行为
采食 · 饮水 · 活动 · 休息 · 产蛋→ 体况
体况评分 · 体温(热红外)→ 蛋品质
产蛋记录 · 品质指标→ 孵化性能
孵化率 · 繁殖性能
已有基础只到第一环:群体级目标检测(本页 01–06 节)。从「个体」往右的四环都还没做,是接下来的重点。
大概怎么做:三阶段
在现有检测模型基础上加个体身份识别与长期跟踪,再做行为识别、体况评分。产出:带 ID 的个体轨迹 + 行为标注集。
前提是阶段一能稳定输出个体级行为统计,且能拿到个体/笼位级的产蛋、蛋品质、孵化记录。产出:行为统计与生产记录对齐的数据库、关联分析模型。
前提是阶段二找到了与性能下降相关的行为信号。产出:异常行为 / 生产性能下降的预警模型,以及「提前多久能发现」的评估。
研究生阶段的重心大致对应「阶段一」:把它做扎实,并把数据采集设计成能直接支撑阶段二(统一时间戳、个体 ID、生产记录对得上)——这样后面接手的人、或自己继续读博,都能直接往下做,不用推倒重来。
现在就能开始的几件事
| 方面 | 具体做什么 |
|---|---|
| 技术上先跑通 | 用现有最优检测模型 + Ultralytics 自带的跟踪器,在 PIO 的原始视频上跑出第一版个体轨迹;统计 ID 切换(同一只鸡被误判成新个体)有多频繁、主要发生在什么情况下;把家禽跟踪/行为识别相关论文读进文献库 |
| 和导师、养殖场确认 | 种鸡场的实际采集条件(机位、有无热红外);能不能拿到个体或笼位级的产蛋、蛋品质、孵化记录;体况评分用哪一套标准 |
| 先定规范 | 行为类别表和标注规范初稿;个体 ID、时间戳的统一规则;与课题组其他方向(马岗鹅等)对齐数据规范,避免各做各的 |
这条路线和三阶段划分来自课题组的协同研究技术路线图,完整版(含研究现状对照表、7 步全流程详解)见 种鸡智能监测 · 后续研究规划;本节只摘和下次汇报直接相关的部分。